


亚马逊标题和主图改了一轮又一轮,转化还是不动:这条 Amazon 美甲绘制笔 Listing 真正输在那张几乎空白的详情页
一条 Amazon 美甲绘制笔 Listing 在标题、主图和五点文案上改了一轮又一轮,页面看起来越来越完整,转化却始终没有明显起色。团队一度怀疑广告结构、竞价策略或价格带,但 DeepBI 将它与同形态、同使用场景且竞争力更强的标杆竞品逐项对标后,得到 56 分对 83 分。差距并不平均:主图领先 1 分,五点打平,标题只差 4 分,真正被拉开的是详情页,4 分对 23 分,相差 19 分。目标 Listing 的详情页只有纯文本,没有图片模块,整条说服链是断的。后续优化没有继续停在标题和主图上,而是先把详情页从零搭起来:先验证精度与色彩,再讲使用步骤和干燥时间,最后才谈场景与礼品属性;同时重排主图说服顺序,把标题核心词权重往前挪。对 Amazon 卖家而言,当广告和页面看起来都在动、转化却不动时,问题往往不在反复修改的那一块,而在从未认真做过的那一块。
这是一条 Amazon 美甲绘制笔类目 Listing 的真实诊断复盘。团队此前的精力几乎都压在标题关键词、主图风格和五点文案上,改了一轮又一轮,页面看起来越来越“完整”,但转化始终没有明显起色。团队一度怀疑问题出在广告结构、竞价策略,或者价格带本身。
DeepBI 把这条 Listing 和类目里一个同形态、同使用场景、竞争力更强的标杆竞品放进同一套评分维度逐项对标,结果是 56 分对 83 分。差距并不平均:主图甚至领先 1 分,五点打平,标题只差 4 分。真正被拉开的是详情页——4 分对 23 分,差 19 分。
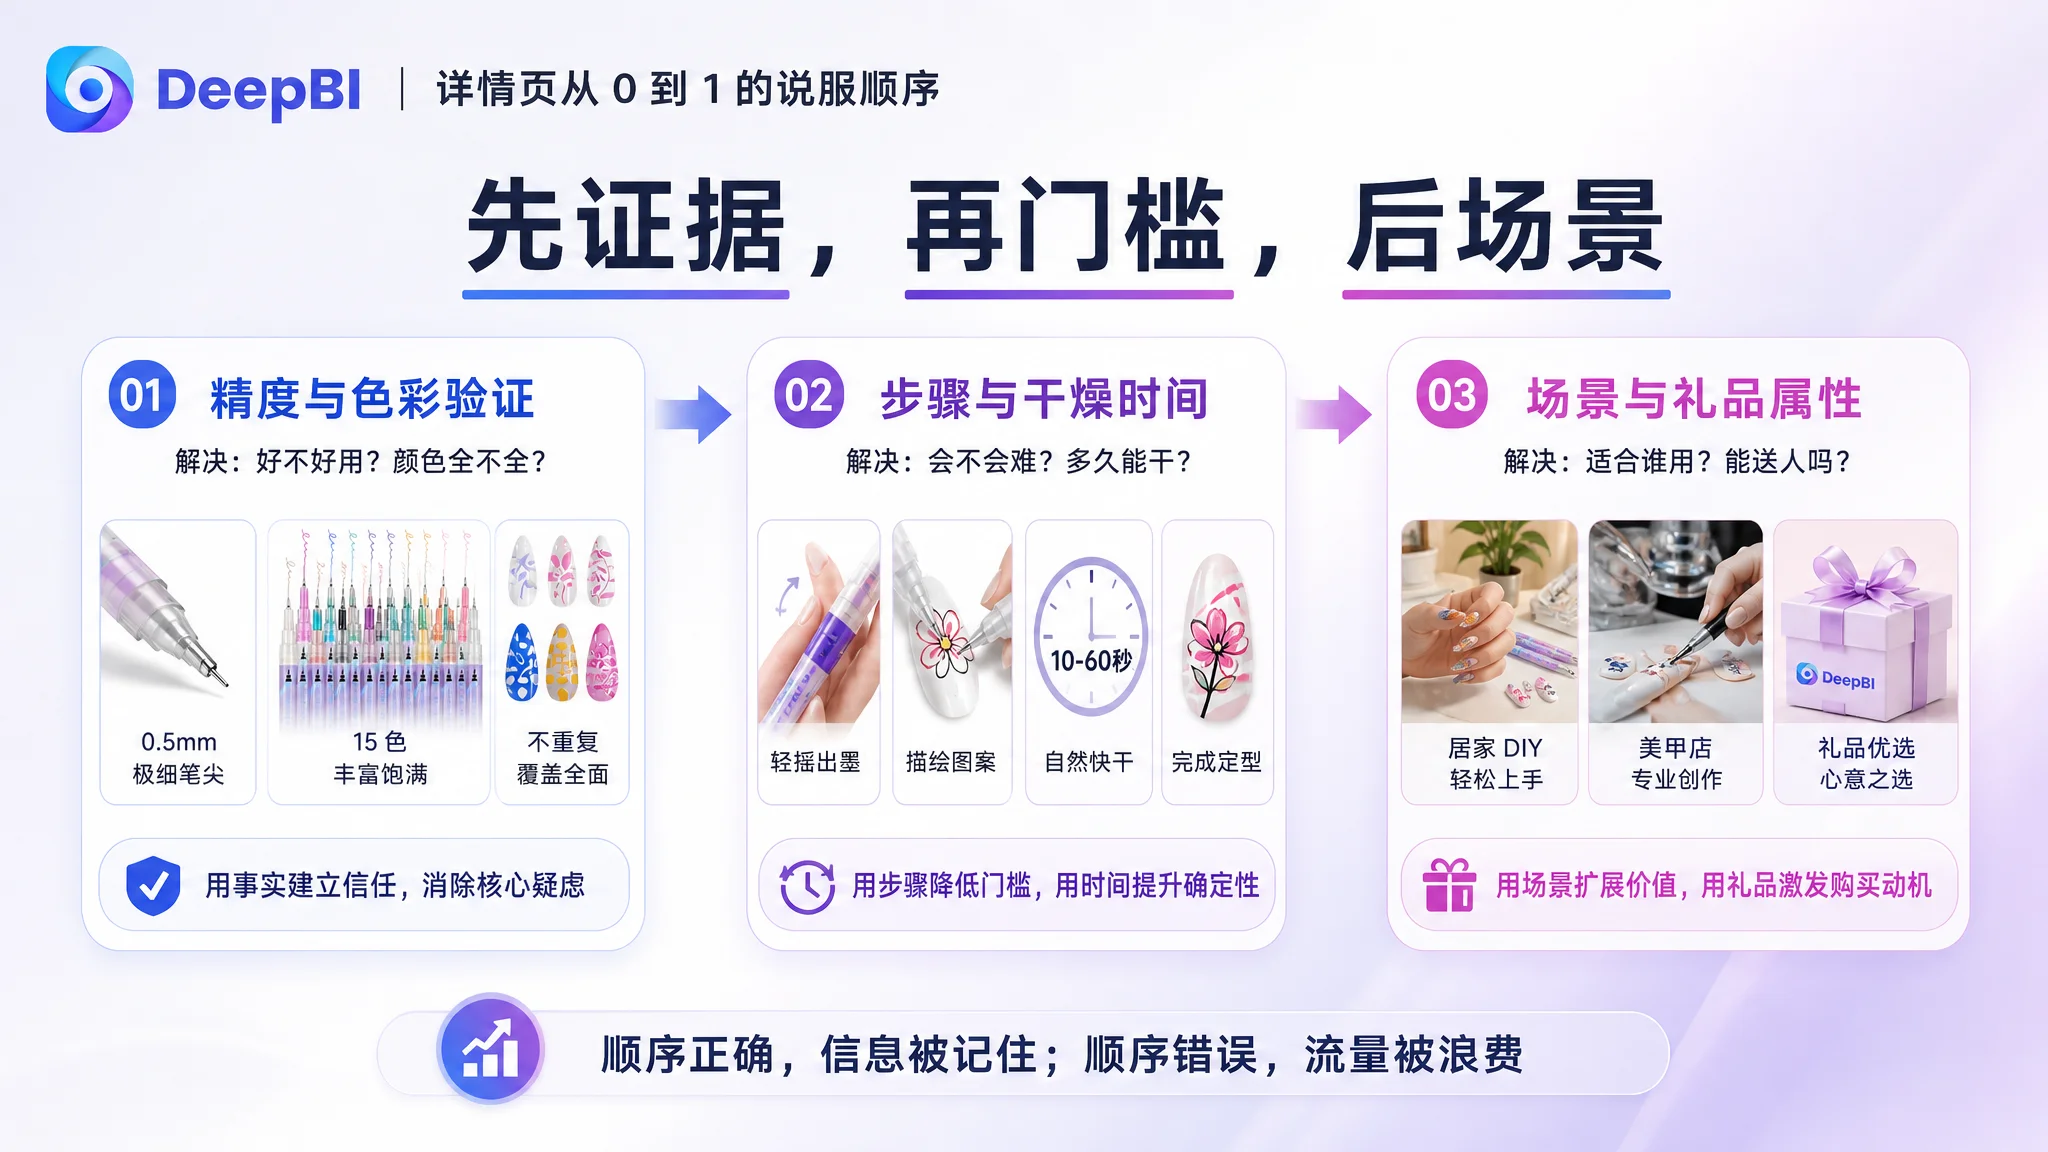
后续的优化重点因此没有继续停在标题和主图上,而是先把这块几乎是空白的地方从零搭起来:先验证精度与色彩,再讲使用步骤和干燥时间,最后才谈场景与礼品属性。同时重排主图的说服顺序,把标题的核心词权重往前挪。
这件事对其他 Amazon 卖家的意义在于:当广告和页面看起来都在动、转化却不动的时候,问题往往不在你反复修改的那一块,而在你从来没有认真做过的那一块。
一条 56 分的 Listing,失分并不均匀
把两个页面的五个维度摊开看,差距的分布非常清楚。
- 标题: 目标 Listing: 13 / 20, 标杆竞品: 17 / 20, 差距: -4
- 主图: 目标 Listing: 25 / 30, 标杆竞品: 24 / 30, 差距: +1
- 五点: 目标 Listing: 8 / 10, 标杆竞品: 8 / 10, 差距: 0
- 详情页: 目标 Listing: 4 / 25, 标杆竞品: 23 / 25, 差距: -19
- 评价: 目标 Listing: 6 / 15, 标杆竞品: 11 / 15, 差距: -5
- 总分: 目标 Listing: 56 / 100, 标杆竞品: 83 / 100, 差距: -27
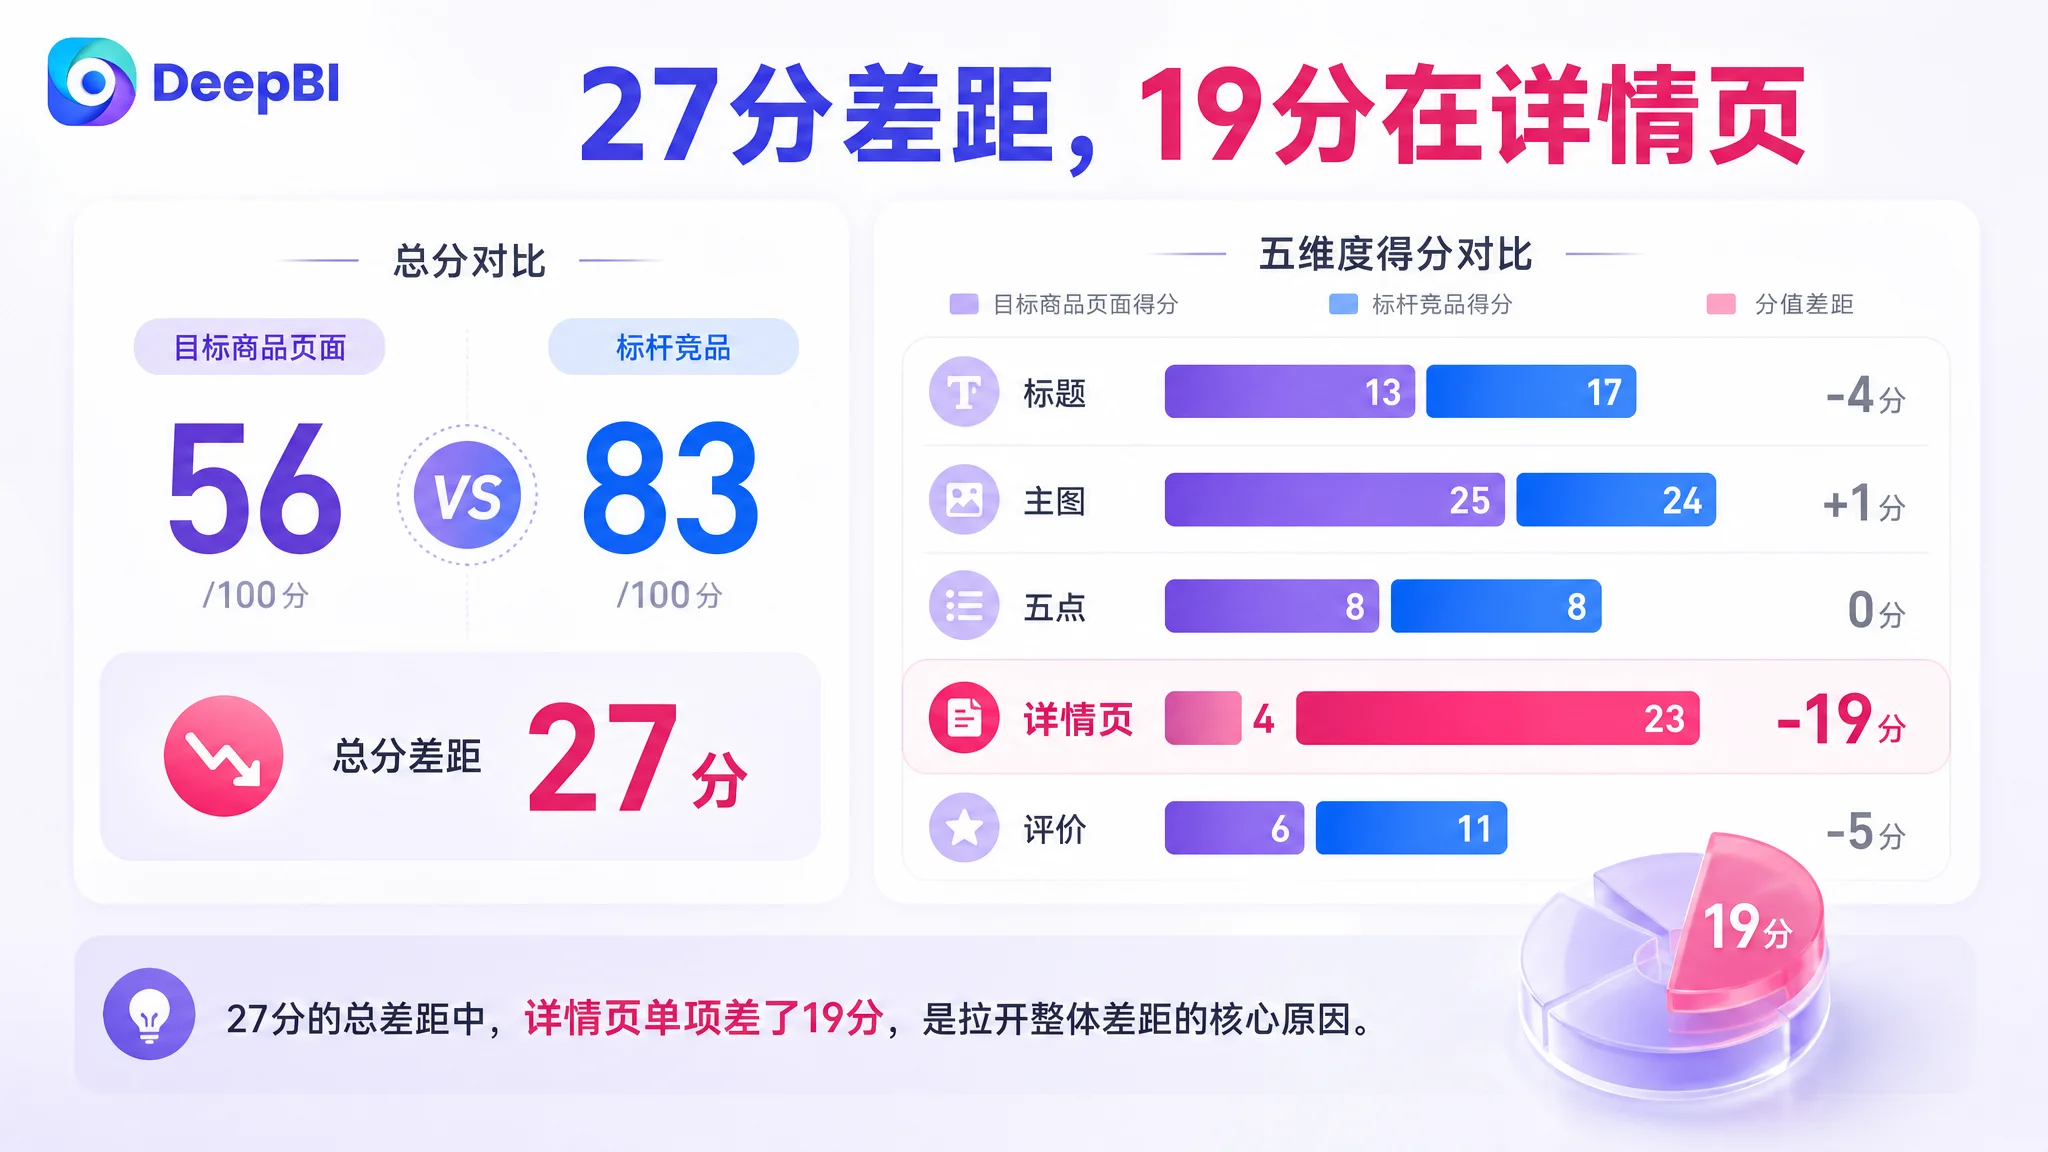
这张表如果只看总分,很容易得出一个模糊结论:整体都需要优化。
但真正有价值的信息藏在分布里。
-27 分里,有 19 分集中在一个维度上。 而这个维度,恰好是团队投入最少的地方。
一条 Listing 不会因为每个环节都差 20% 而失败,通常是因为某一个环节差了一个量级。
客户一直在改的地方,恰好不是失分的地方
回到团队最初的判断。他们认为问题在标题——关键词不够精准,卖点不够突出;也在主图——视觉不够抓人,缩略图里不够显眼。
这两个判断都不能算错,但它们都不是主要矛盾。
主图这一项,目标 Listing 拿到 25 分,比标杆竞品还高 1 分。也就是说,在“视觉质量”这个层面,页面并不落后。五点描述 8 分对 8 分,完全打平;而且从结构上看,目标 Listing 用的是“痛点 → 解决方案”的展开逻辑,防堵墨、快干防水这些具体承诺都带数据支撑,说服密度甚至比竞品更扎实。
标题确实有差距,4 分。核心关键词“Nail Art Pens Set”被放在了品牌名之后,而竞品是直接前置;长尾词覆盖也不够,竞品把“Dual Tip”“24 Colors”“Non-Toxic”“Acrylic Nail Kit”“French Manicure”“Gifts for Mom, Friends”这一串高价值词都装了进去。
4 分是真实的损失,但它解释不了为什么页面“看起来已经不错”,转化却起不来。
这就带出一个更关键的问题:团队把 80% 的优化动作,投在了只占 15% 差距的地方。
广告把人带到页面,页面没把人留下来
Amazon 的流量逻辑有一个容易被忽略的顺序:广告负责把人带进来,Listing 负责把人留下来。
带进来之后发生什么,广告控制不了。
用户点进页面,看到主图,看到价格,看到星级,然后往下滑。如果在这个下滑的过程里,他没有获得足够的信息来打消疑虑,页面就到此为止了。广告费照扣,订单没有。
广告放大的不只是产品的优势,也可能是页面的缺陷。
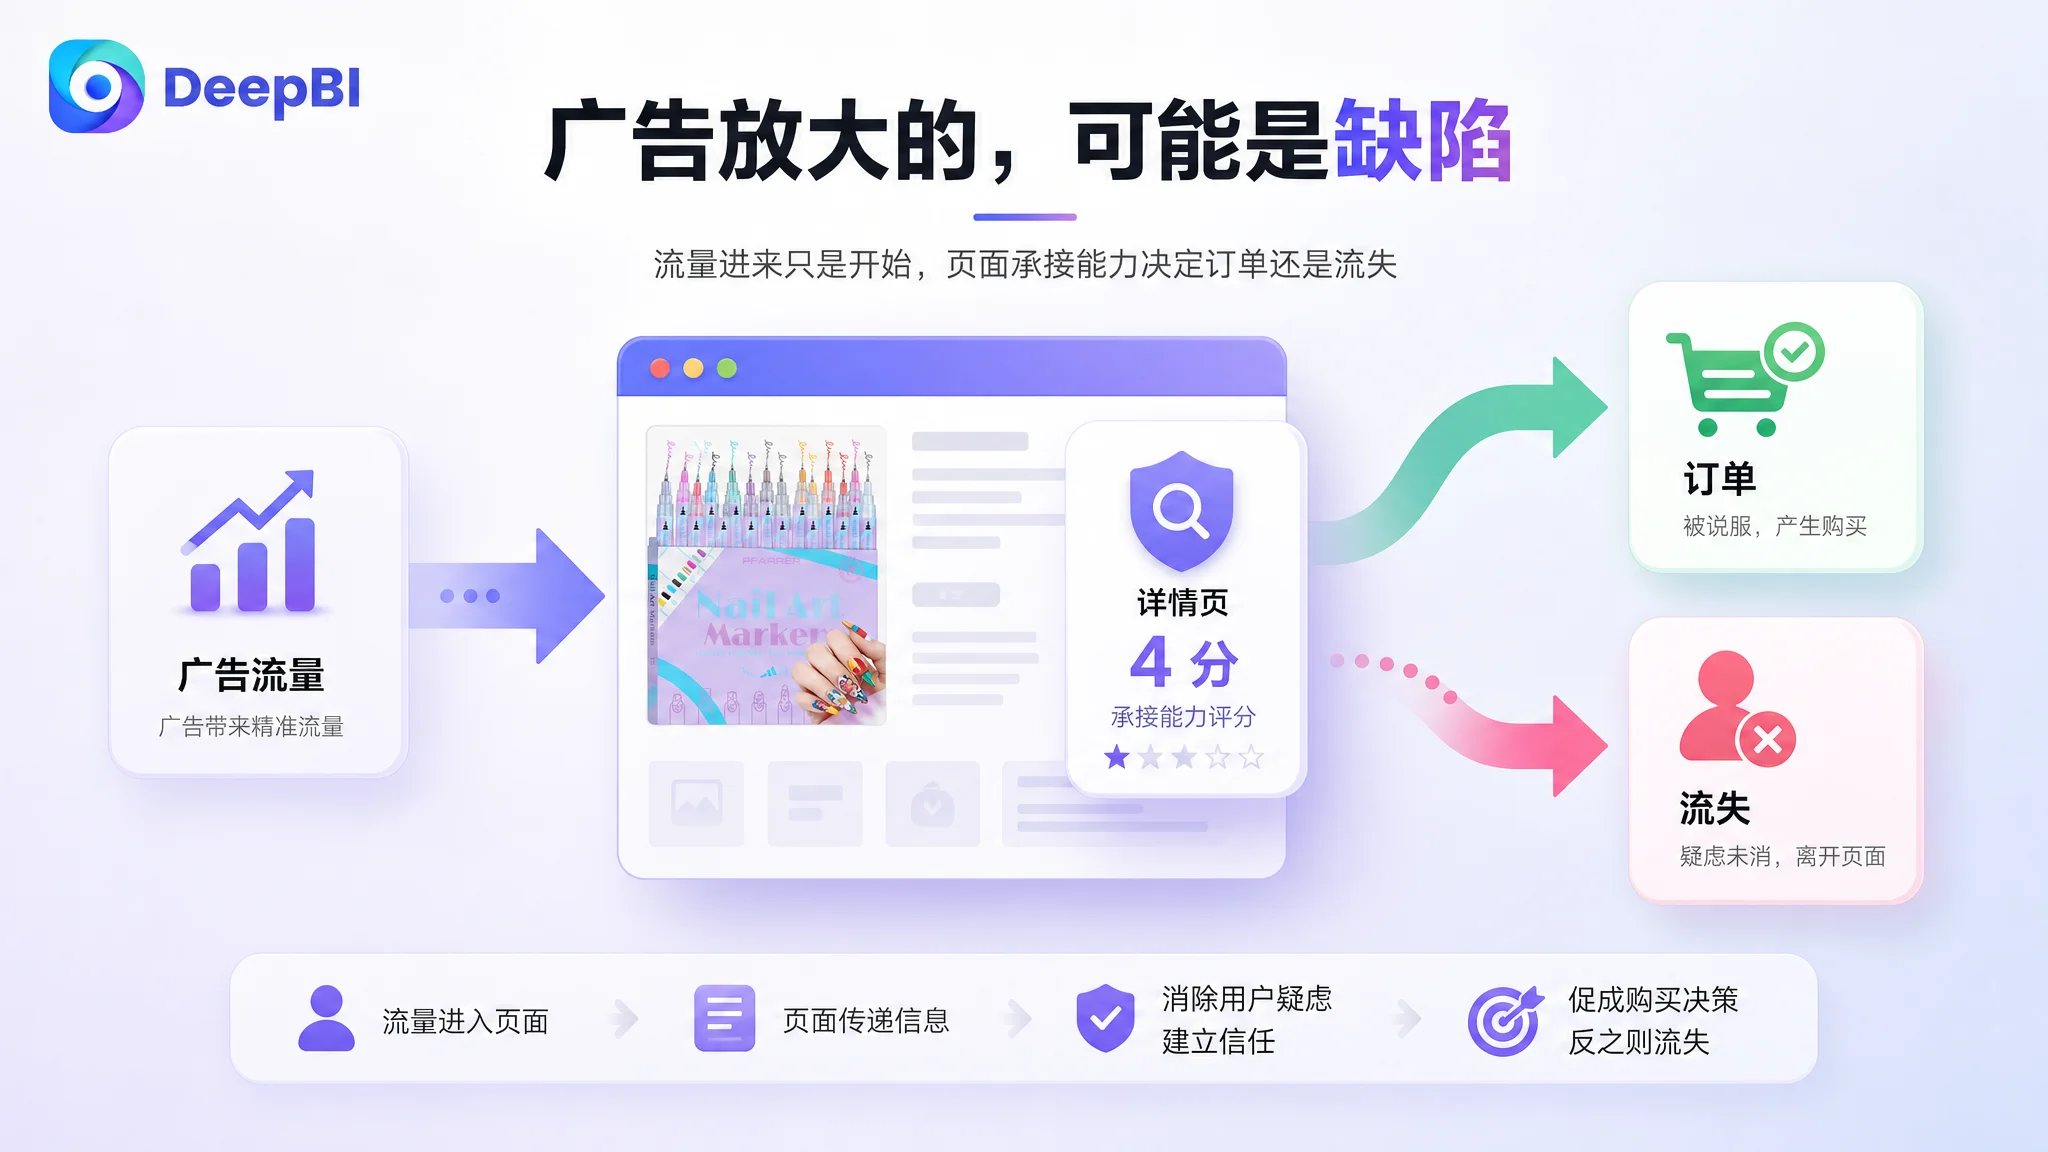
这条 Listing 的问题就卡在这里。它不是一个“没人看”的页面,而是一个看了之后无法被说服的页面。
详情页不是“少了几张图”,而是整条说服链是断的
目标 Listing 的详情页得分是 4 / 25。
原因很直接:它是一段纯文本,没有任何图片模块。
竞品的详情页是 23 分,由产品包装展示、双笔尖结构图、20 多款设计示例图、4 种技法场景图、4 步使用指南图、3 类使用场景图(居家 DIY、美甲店、礼品),再加上 6 个图标化的卖点模块组成。
差距不只是“有图”和“没图”,而是两种完全不同的信息组织方式。
用户在脑子里拼不出这个产品
用户买美甲笔,脑子里要回答的问题很具体:笔尖到底多细?15 个颜色是不是有重复?我这种没画过的人能不能画出来?画完要等多久能干?
纯文本回答这些问题,效率极低。用户需要自己在脑子里把文字翻译成画面,大部分人不会做这个翻译,会直接离开。
卖点全在文字里,等于没有被强调
“0.5mm 极细笔尖”“防堵墨系统”“10-60 秒快干”——这些都是真实且有力的卖点。
但它们被埋在段落里,和“无毒”“舒适握持”“适合所有水平”混在一起,没有任何视觉层级。用户扫过去,一个都没记住。
卖点没有被视觉强化,就等于没有被讲过。
竞品做的不是图,是信任模块
竞品的详情页里有一层更深的东西:场景化定位和信任符号。
居家 DIY、美甲店、派对赠礼——这些标签把产品从“一支笔”扩展成“一种使用场景”。Non-Toxic、Long-Lasting 这类图标化的认证标签,则是在替用户完成风险评估。
这套结构解决的不是“产品好不好”,而是“我买它会不会错”。
标题那 4 分,丢在搜索入口上
标题的问题需要单独说,但优先级要往后放。
差距集中在三处:核心词位置、卖点丰富度、长尾覆盖。
竞品的结构是“核心关键词 + 具体卖点 + 使用场景 + 礼品属性”,是一个已经被验证过的成熟公式。目标 Listing 的标题更接近功能列举,关键词靠后,场景化表达缺失。
调整方向是明确的:把“0.5mm Fine Tip Nail Art Pens Set”这类核心词提到前段,补进“Nail Art Markers”“DIY Home & Salon”“French Manicure Tool”这些长尾入口,再把“Non-Toxic”和礼品属性补齐。
但这 4 分补上,也不会改变整体的转化结构。标题决定的是有多少人进门,详情页决定的是进门的这些人里有多少人买单。 在后者还是 4 分的时候,前者的边际收益是有限的。
3.7 星对 4.1 星:这条差距不是一次优化能解决的
评价维度差 5 分,比标题还多 1 分,但它属于另一种性质的问题。
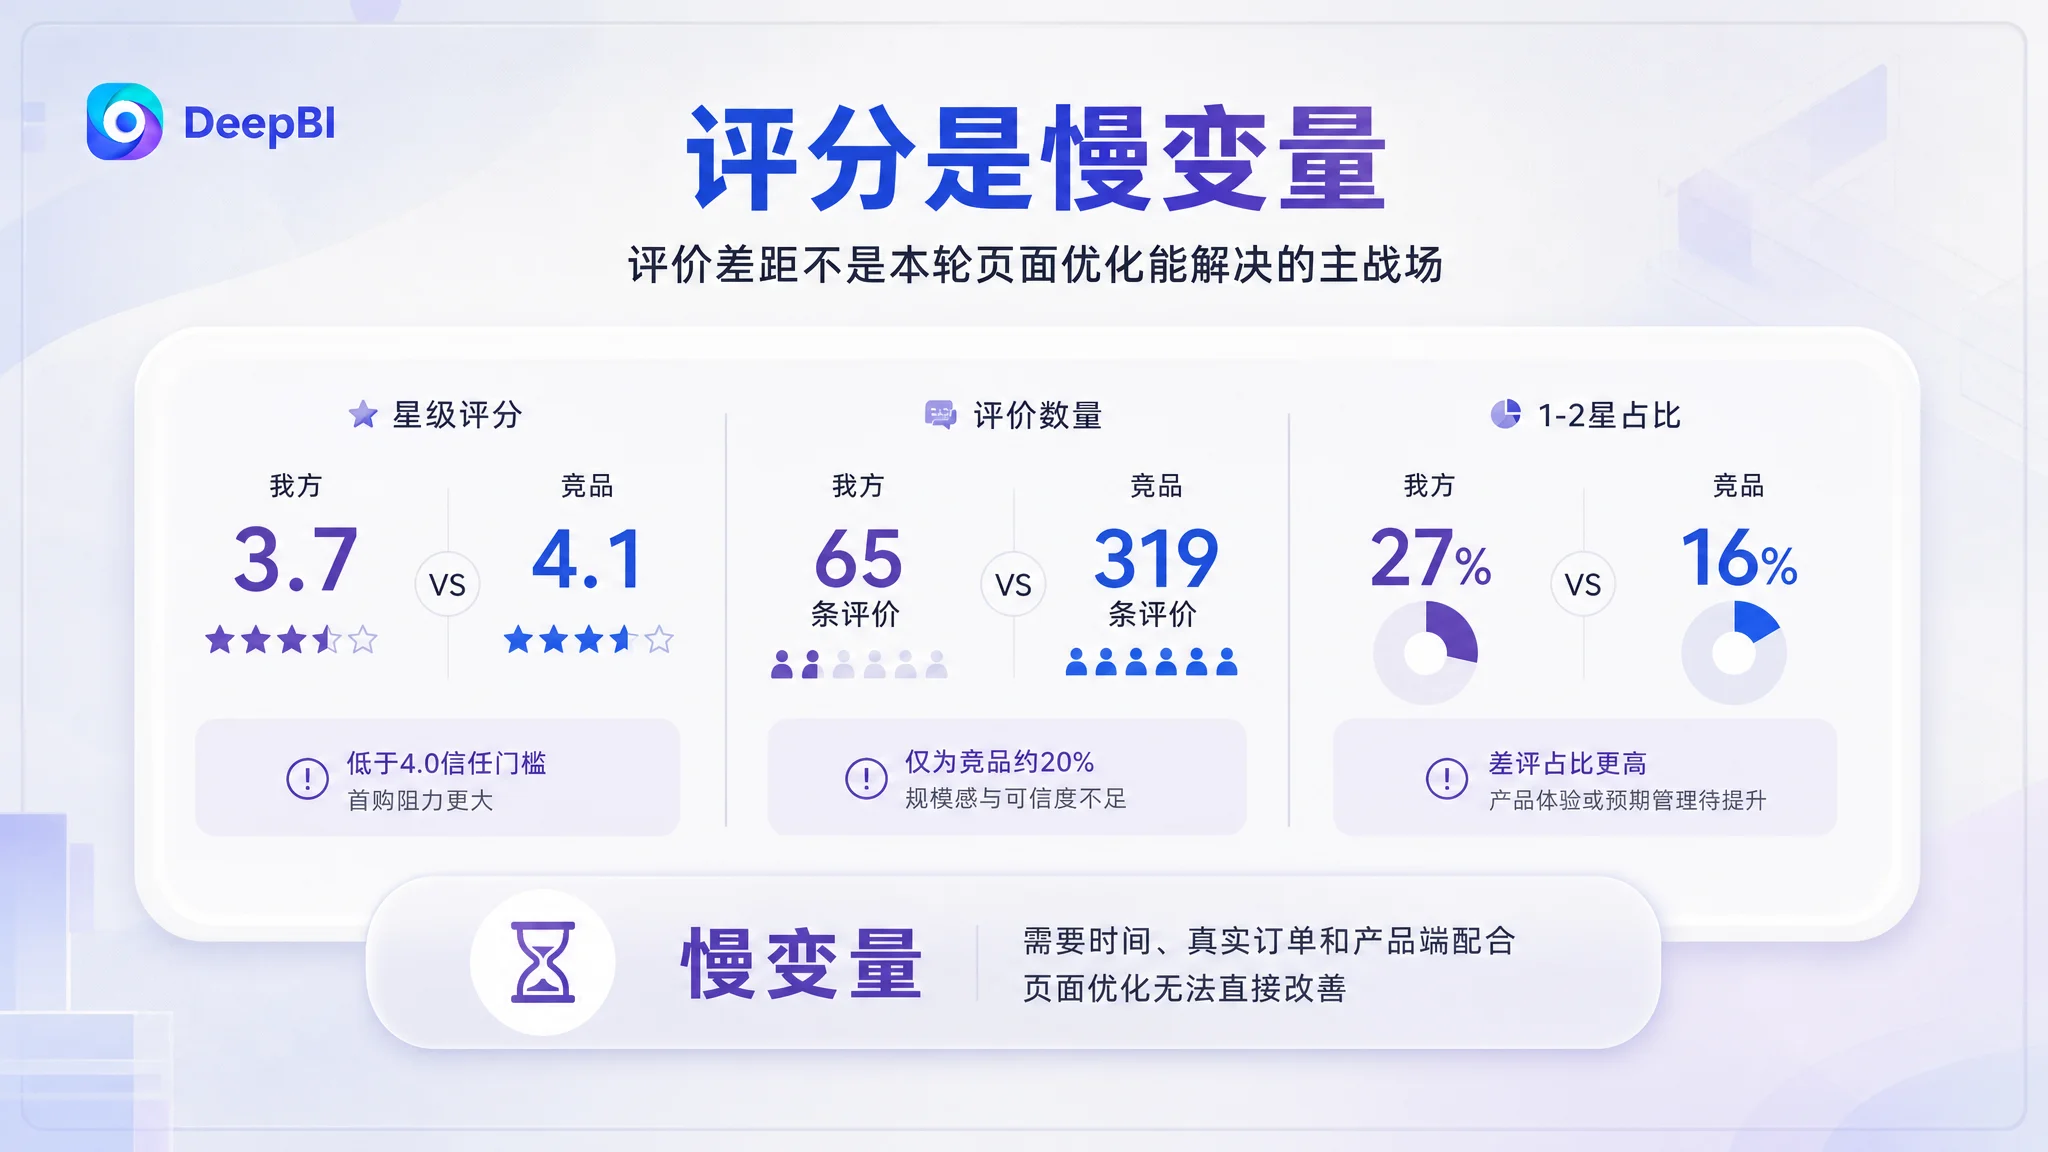
目标 Listing 是 3.7 星、65 条评价,1-2 星占比约 27%。竞品是 4.1 星、319 条评价,1-2 星占比约 16%。
三个差距叠在一起:
- 3.7 星低于 4.0 这条隐性的信任门槛,首购阻力明显更大
- 评价数量只有竞品的约 20%,规模感和可信度都不足
- 差评结构更差,说明产品体验或预期管理存在问题
而且竞品页面上已经有 AI 评论摘要、多维标签(质量、易用性、颜色、干燥时间),还有产品视频和用户视频评论。目标 Listing 这些都还没有。
这里必须说清楚一件事:评分和评价数量是慢变量,页面优化解决不了它。 它需要时间、需要真实订单、需要产品端和预期管理端的配合。
所以在这一轮优化里,评价不是主战场,但它是必须被记录下来的长期风险项——因为它会持续压低详情页好不容易建立起来的说服力。
所以 DeepBI 没有先去动广告和价格
这是整个案例里最关键的一个判断。
当一条 Listing 的详情页只有 4 分、评价低于信任门槛时,继续加大广告投放意味着什么?
意味着用更高的成本,把更多的流量送进一个接不住的页面。
在承接能力修复之前放量,等于放大缺陷。
这也是为什么优化的顺序不是“先看广告数据、再调竞价”,而是先把页面的成交结构补起来。当页面具备了基本的说服能力,广告的每一分钱才开始有对应的回报。
决策的关键不是“哪个问题最重要”,而是“哪个问题现在解决,其他问题才会跟着变好”。
优化是怎么排序的
顺序本身就是决策。
第一步,把详情页从 0 搭到 1。
不是简单堆图,而是按用户决策的心理顺序排七个模块:先亮出 15 支笔的实物,解决“套装是否完整”的第一疑虑;接着用微距图把 0.5mm 笔尖放大,把“精细”这个核心优势变成看得见的事实;然后展示 15 个颜色在甲片上的实际效果,证明不重复;再用花卉、纹理这类精细图案验证能力边界;随后用具体步骤和 10-60 秒的干燥时间,把操作门槛讲透;最后用握持手感和安全成分回应“会不会累、会不会不安全”,并说明新手和老手都适用。
第二步,调主图的说服顺序。
主图分数虽然领先,但顺序有问题。原本放在第四位的“高品质验证”被前移到第三位,用图标化的方式直接回应快干、无毒、不晕染、水基安全这几个核心疑虑。
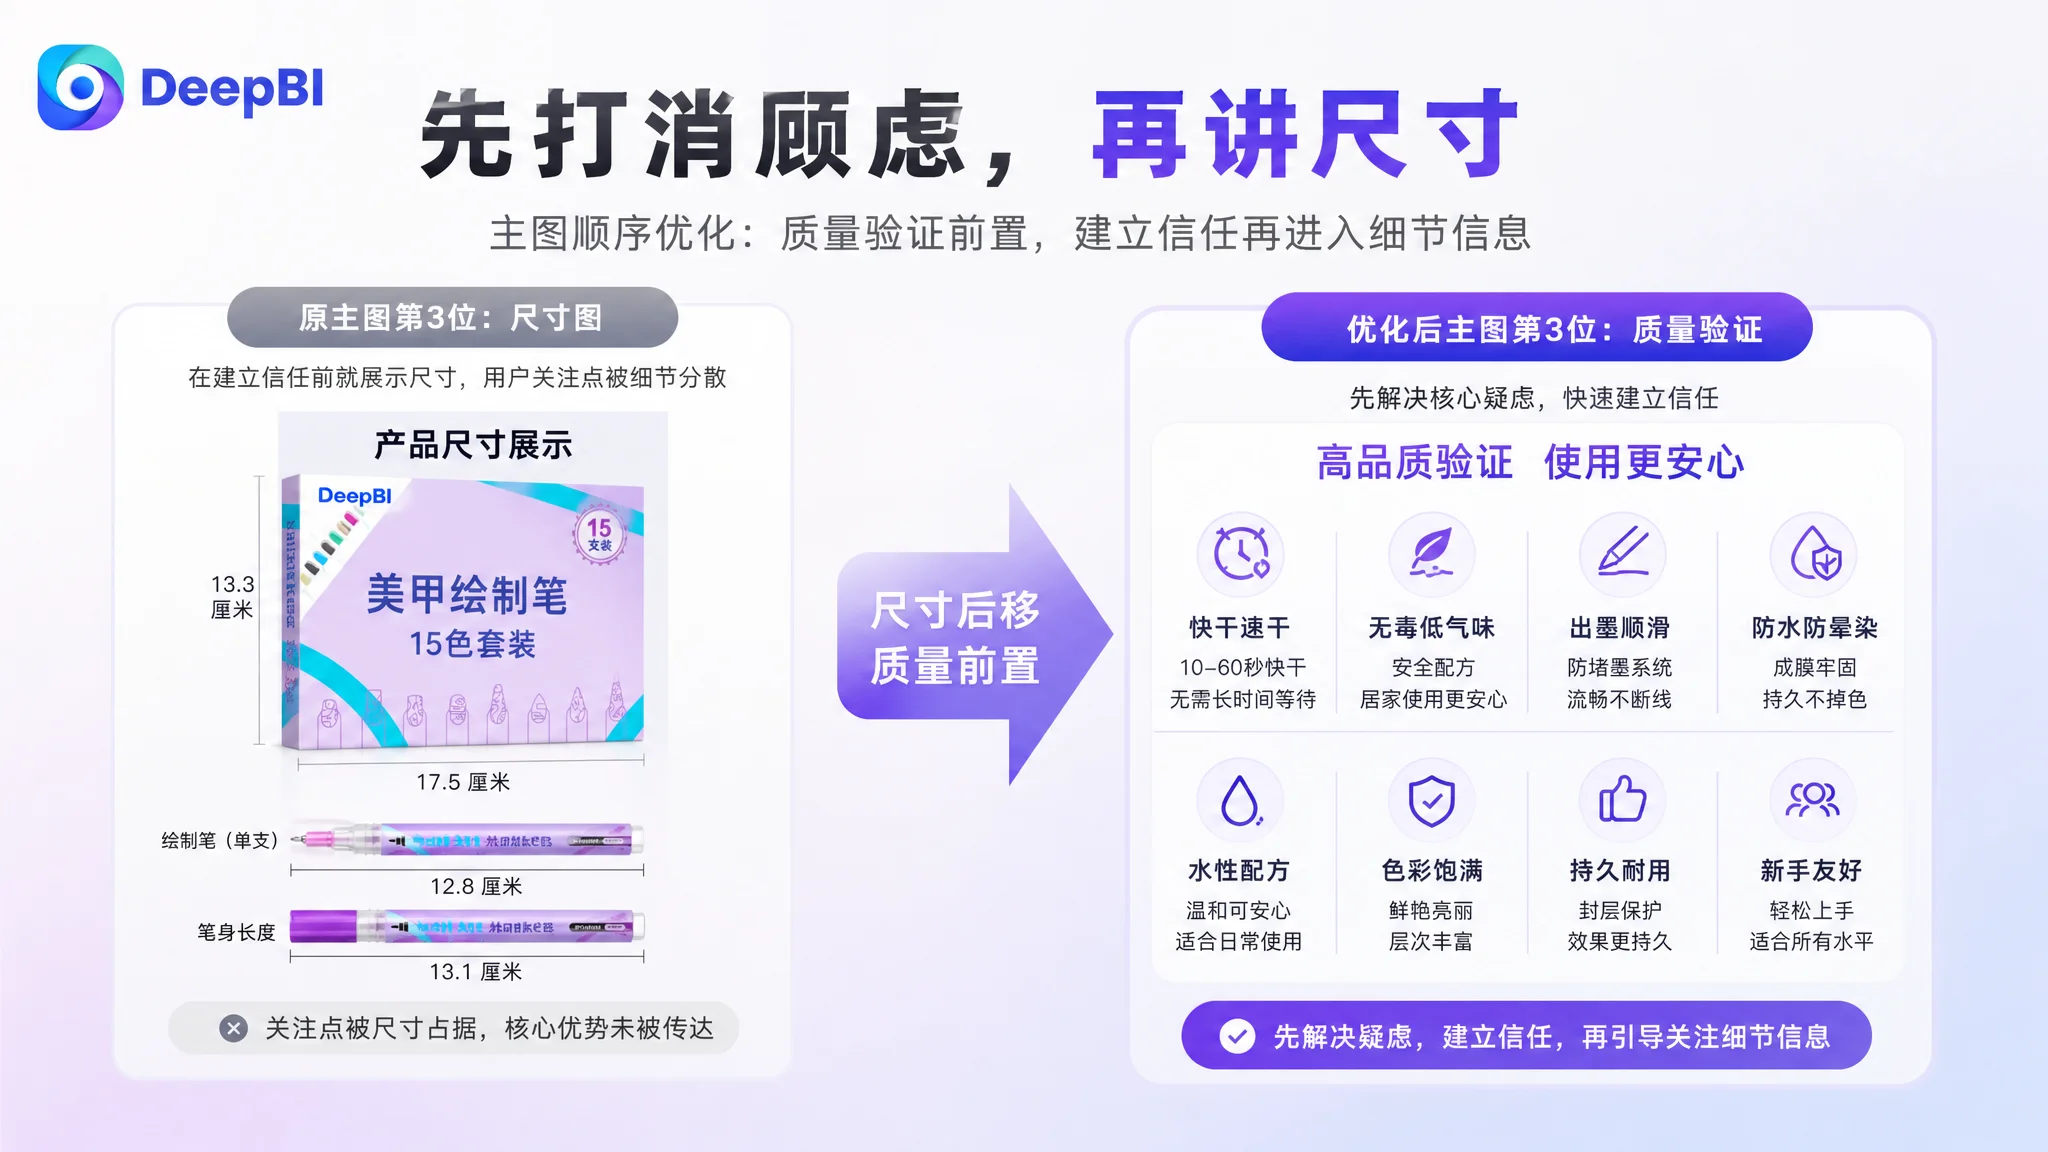
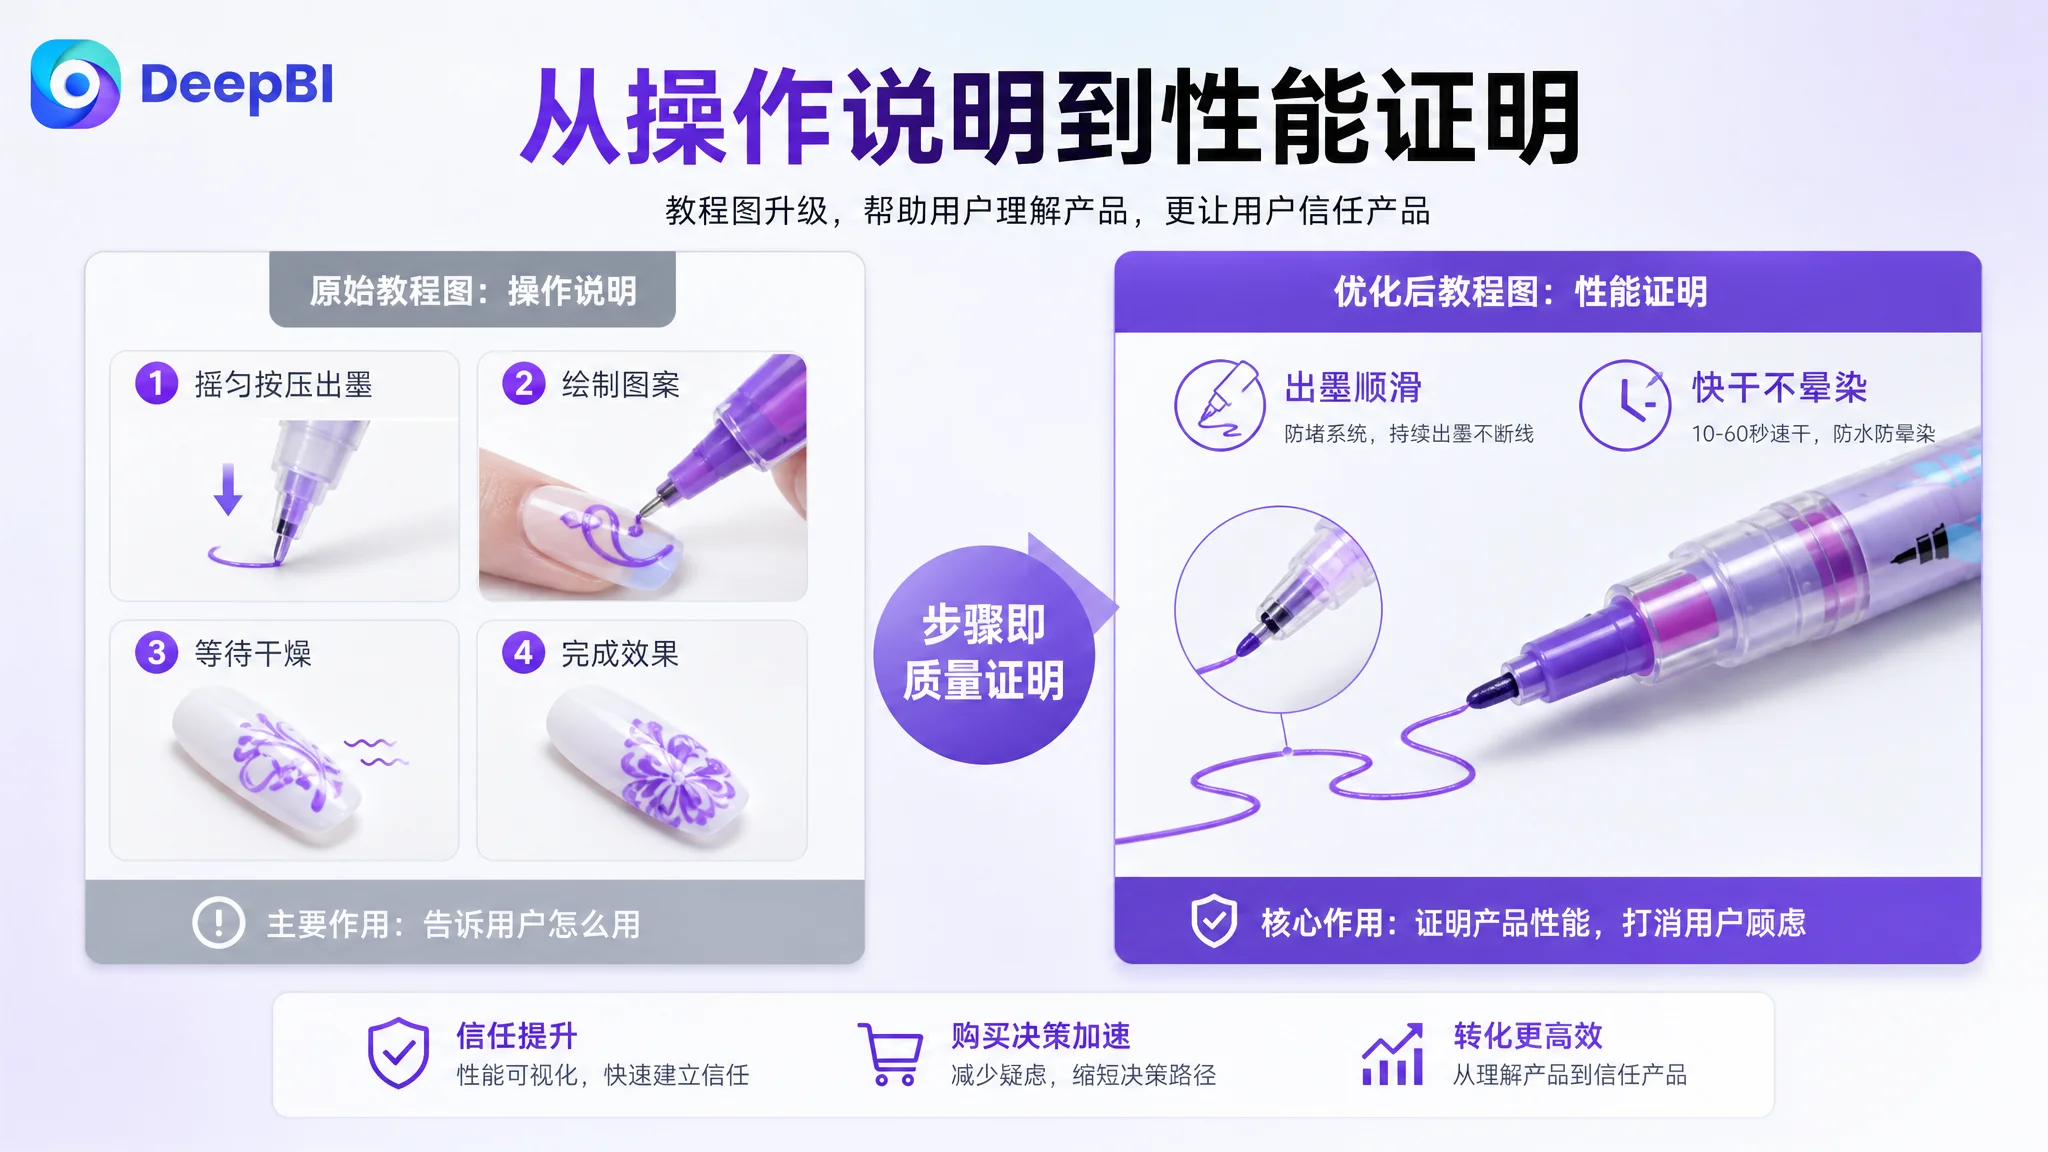
尺寸图被往后挪,因为它出现在信任建立之前,是一个逻辑死胡同。使用教程图则被要求明确挂上“出墨顺滑”“快干不晕染”这些性能点,让操作指引本身成为质量证明。
第三步,重排标题权重。
核心词前置,补长尾入口,补安全属性和礼品场景。
第四步,五点结构保留,补场景。
五点的“痛点 → 解决方案”逻辑本来就是优势,不需要推翻。只需要在最后一点把“适合所有技能等级”和礼品场景结合,把节日的具体使用场合写进去,拓宽搜索权重。
一个容易被忽略的细节:为什么建议避开“大面积绘画”
这条 Listing 有一个非常具体的产品特征:0.5mm 单细笔尖。竞品是双头设计,细头加粗头。
在“大面积涂色”这个维度上,单细笔尖是劣势。
所以优化建议里明确要求:展示时避开大面积绘画、书法这类弱项,集中聚焦花卉、纹理、线条、圆点、几何图案这些精细局部的勾勒。
把 0.5mm 从“只能画细的”重新定义为“能画到别人画不到的精度”。
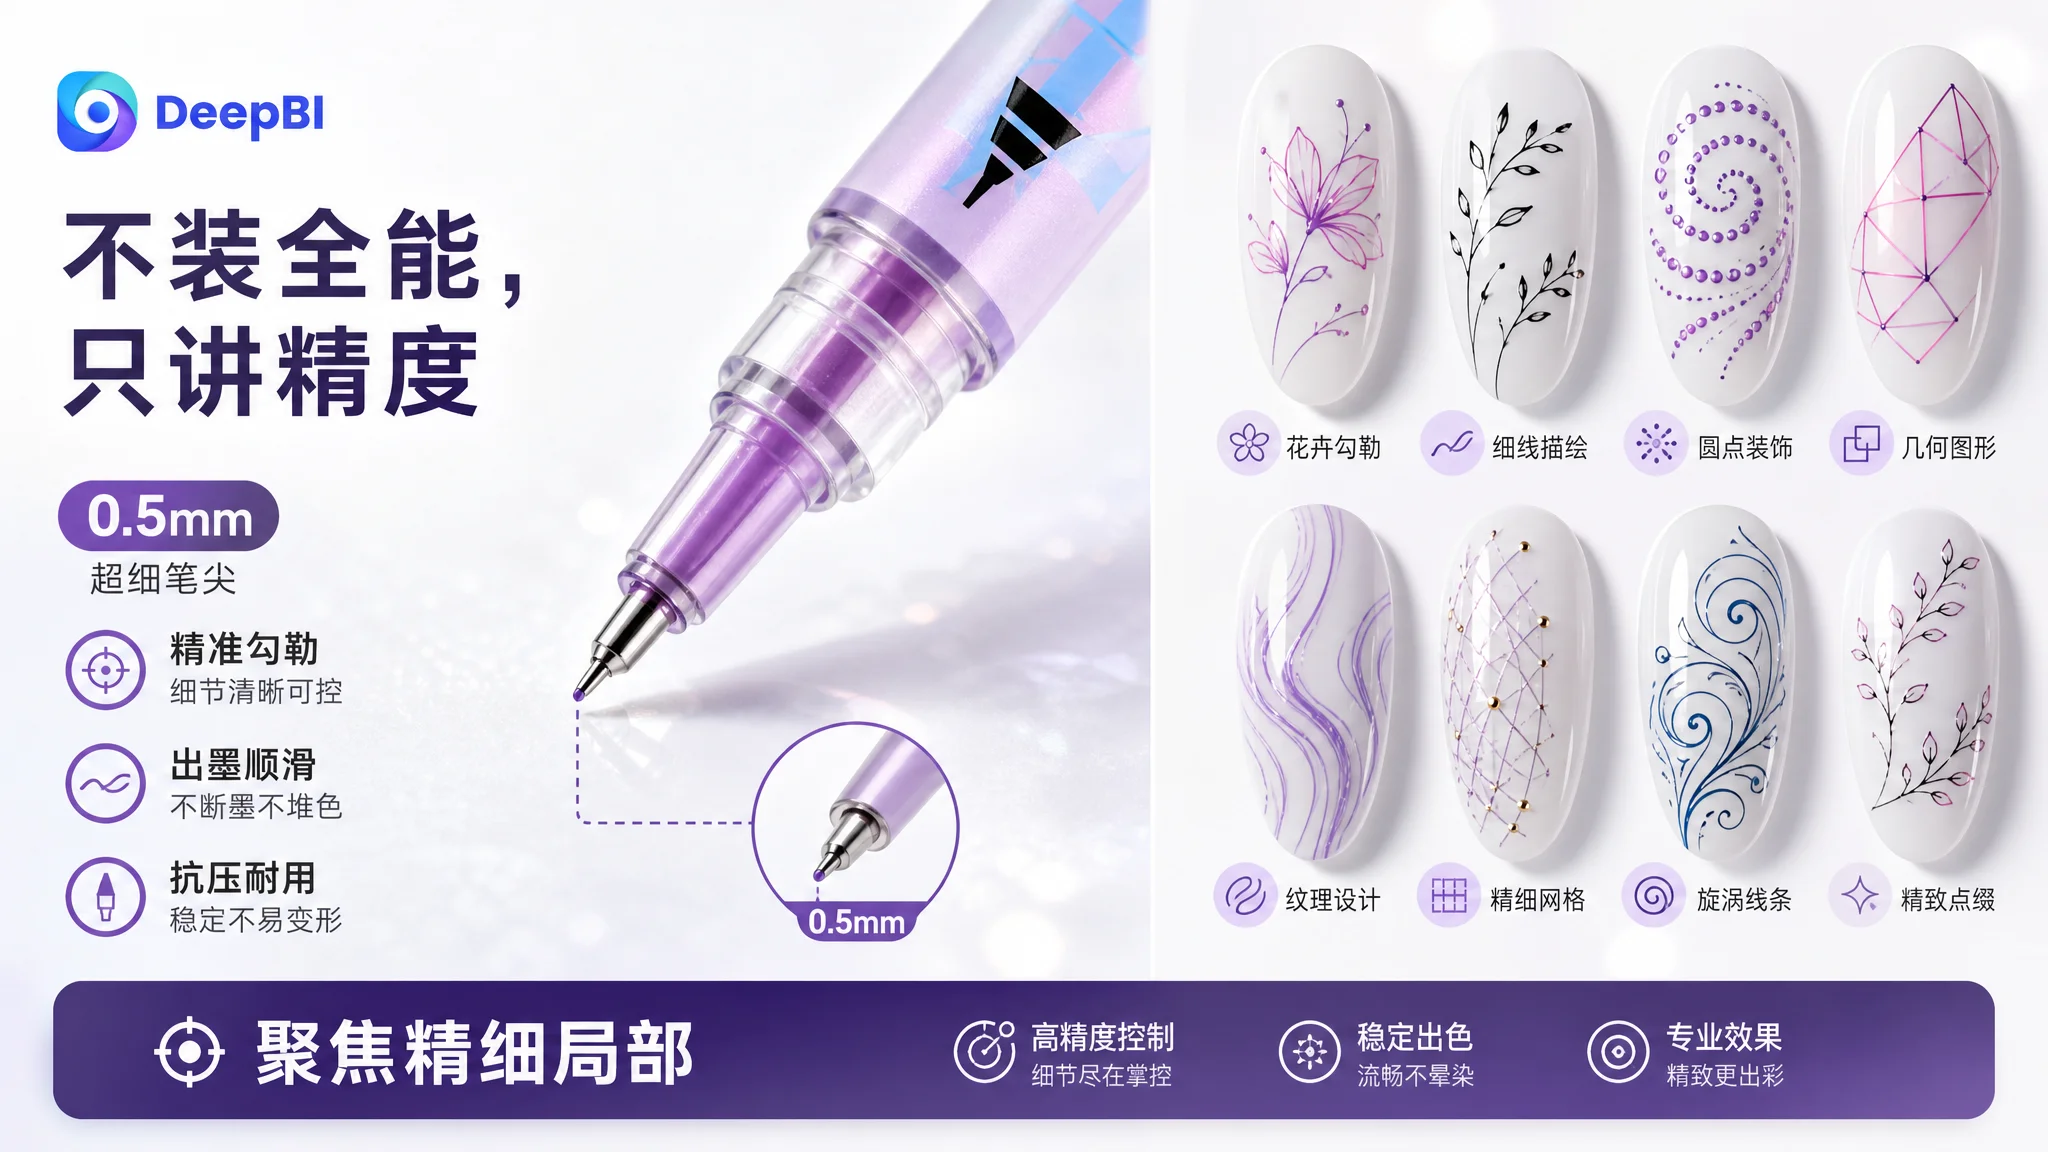
这是一个典型的边界内决策:不虚构产品不具备的能力,不承诺它做不到的效果,而是在真实能力范围内找到最强的那一面。
好的优化不是把产品说成另一个产品,而是让用户看清楚它到底是什么。
真正的变化,发生在判断顺序上
这个案例里没有可以对外复述的漂亮数字。页面诊断刚完成,优化动作刚确立,效果还没有走完一个完整的验证周期。
但有几件事已经发生了变化。
结构上,详情页从“纯文本堆砌”变成了有层级的说服链,从参数罗列变成了证据展示。主图从“结果画廊”变成了“疑虑消解序列”。标题从功能列举变成了搜索入口布局。
风险上,最重要的一条是:广告不再被用来填补页面的转化缺口。在详情页只有 4 分的时候放量,本质上是在为页面的缺陷付费;现在这个风险被识别出来了,也被排到了优化队列的最前面。
认知上,团队第一次意识到,他们过去反复打磨的标题和主图,其实已经是这条 Listing 相对健康的部分。真正让流量白白流失的,是他们从来没有认真做过的那一块。
优化最难的部分,从来不是把某个模块做得更好,而是判断哪个模块现在最值得做。
这件事对其他 Amazon 卖家的意义
如果你正在面对“广告在跑、页面在改、订单不动”的局面,有三个问题值得先自查一遍。
第一,你的五个维度分数,差距是均匀的,还是集中在一个点上?
如果是均匀的,说明是整体水位问题,需要系统性重做。如果是集中的,那 80% 的优化精力应该压在那一个点上,而不是平均分配。
第二,你的详情页,是“信息”还是“证据”?
纯文本的参数描述是信息。用户需要自己完成从信息到信任的转换。而图片、对比、步骤、场景、认证标签,是把转换过程替用户做完。前者是说明书,后者是销售。
第三,你现在的广告预算,是在放大优势,还是在放大缺陷?
这个问题在投放报表里看不出来,只能在页面承接能力里看出来。
美甲笔这个类目的竞争已经很密,头部竞品的页面成熟度摆在那里。在这种环境里,靠单点修补赢不了,靠持续加预算也赢不了。
真正能改变结果的,是先看清楚失分到底集中在哪一块,然后按正确的顺序去补。
这也是 DeepBI 在这类 Amazon Listing 诊断里最核心的作用——不是给出更多建议,而是给出先做哪一个的判断。
想了解更多DeepBI能为您做什么?
联系我们,获取免费咨询和定制化广告优化方案
