


亚马逊主图分数没输,转化却接不住:这条 Amazon 魔术贴理线带 Listing 真正丢单在几乎空白的 A+ 详情页
这条 Amazon 美国站的可重复使用魔术贴理线带 Listing,处在类目拥挤、价格带和功能都接近的环境中,曝光与点击都有,订单却始终起不来,ACOS 也越压越紧。团队最初把问题归因于关键词、竞价和主图,优化动作也围绕这三项展开。DeepBI 将它与类目高位竞品放在同一张表逐项拆解后,分数分布出现反差:主图一项还领先竞品 1 分,真正拉开总分 27 分差距的是详情页,目标 Listing 为 3 分、竞品为 23 分,整整相差 20 分。其 A+ 内容几乎不存在,只有纯文本描述,没有场景图、对比图、使用步骤图、前后对照和材质特写;竞品则使用场景应用、专业对比、使用步骤、Before/After、多场景拼图和产品特性拆解等图文模块。流量进得来,落地后却没有内容接住。后续优化顺序因此调整为先补页面承接结构,再谈广告放量;对怀疑广告不行的 Amazon 卖家来说,需要先确认花钱买来的点击落地页是否具备承接能力。
这是一条 Amazon 美国站的可重复使用魔术贴理线带 Listing 的优化复盘。类目拥挤,价格带接近,产品功能也接近,客户最初的注意力几乎全部放在广告端:曝光有,点击也有,但订单始终起不来,ACOS 越压越紧。
团队原本的判断很顺理成章——关键词没选对,竞价策略不够精准,或者主图不够打眼。过去一段时间,优化动作基本都围绕这三件事展开。
但 DeepBI 把这条 Listing 和类目里的高位竞品放在同一张表上逐项拆开之后,分数的分布很奇怪:主图这一项,客户其实还赢了竞品 1 分。真正把总分拉开 27 分的,是详情页——3 分对 23 分,整整 20 分。这条链接的 A+ 内容,几乎可以说是不存在的。
也就是说,流量进得来,但落地之后没有东西接住它。后续的优化顺序因此整个调了个方向:先补页面承接结构,再谈广告放量。对所有正在怀疑“广告是不是不行了”的 Amazon 卖家来说,这件事值得先确认一遍——你花钱买来的点击,落地那一页到底有没有在替你说话。
一个很反常的分数分布
先看总分。
这条目标 Listing 的综合得分是 57 分,对标竞品是 84 分,差距 27 分。单看这个数字,很容易得出“整体都需要重做”的结论。
但拆到五个维度,故事完全不一样。
- 标题: 目标 Listing: 13, 竞品: 16, 满分: 20
- 主图: 目标 Listing: 25, 竞品: 24, 满分: 30
- 五点: 目标 Listing: 6, 竞品: 9, 满分: 10
- 详情页: 目标 Listing: 3, 竞品: 23, 满分: 25
- 评价: 目标 Listing: 10, 竞品: 12, 满分: 15
主图是唯一一个正向的维度。
标题落后 3 分,五点落后 3 分,评价落后 2 分——都是可控范围内的结构性差距。
而详情页,3 分对 23 分,一个维度就吃掉了 20 分。
27 分的总分差距里,有 20 分不是输在流量入口,而是输在流量落地之后。
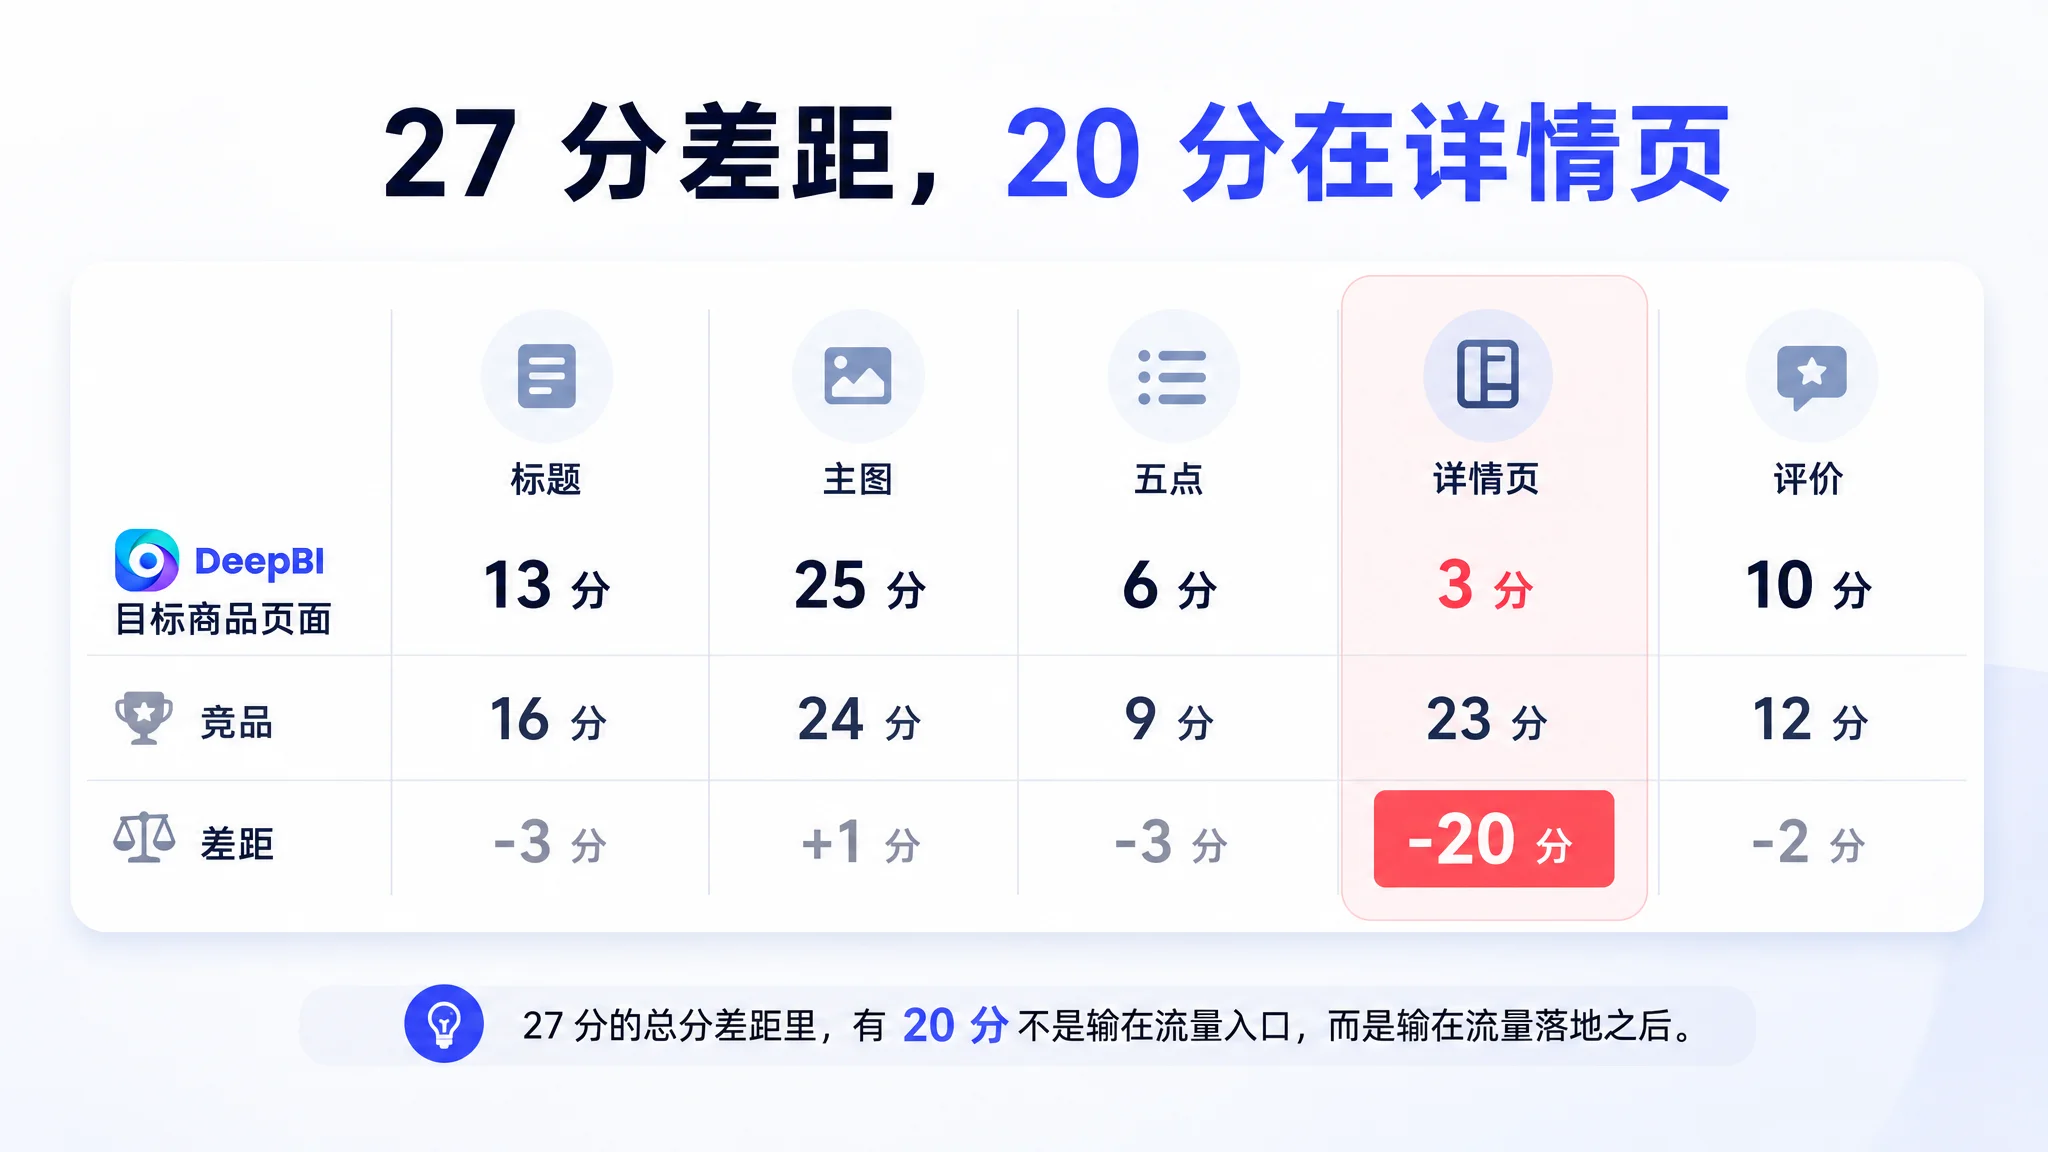
这个分布本身就说明了一件事:这条链接的问题,不在“用户有没有点进来”,而在“点进来之后发生了什么”。
客户一直在调的东西,恰好是它不弱的地方
回到客户最初的判断。
订单起不来、ACOS 压不下去,最常见的归因有三个:关键词、竞价、主图。这是大多数 Amazon 团队的本能反应,因为这三件事最直观、最可操作,也最容易在广告后台看到反馈。
问题是,这条链接的主图并不弱。
25 分对 24 分,它甚至小幅领先竞品。主图的完整度、功能覆盖、信息结构都是齐的。分析里对它的评价是“结构完整”,问题只在于首图在缩略图阶段的密度冲击不够、部分图的呼吸感偏紧——这属于优化的余量,不是拖累转化的病灶。
换句话说,客户一直在动的那个方向,本来就不是瓶颈。
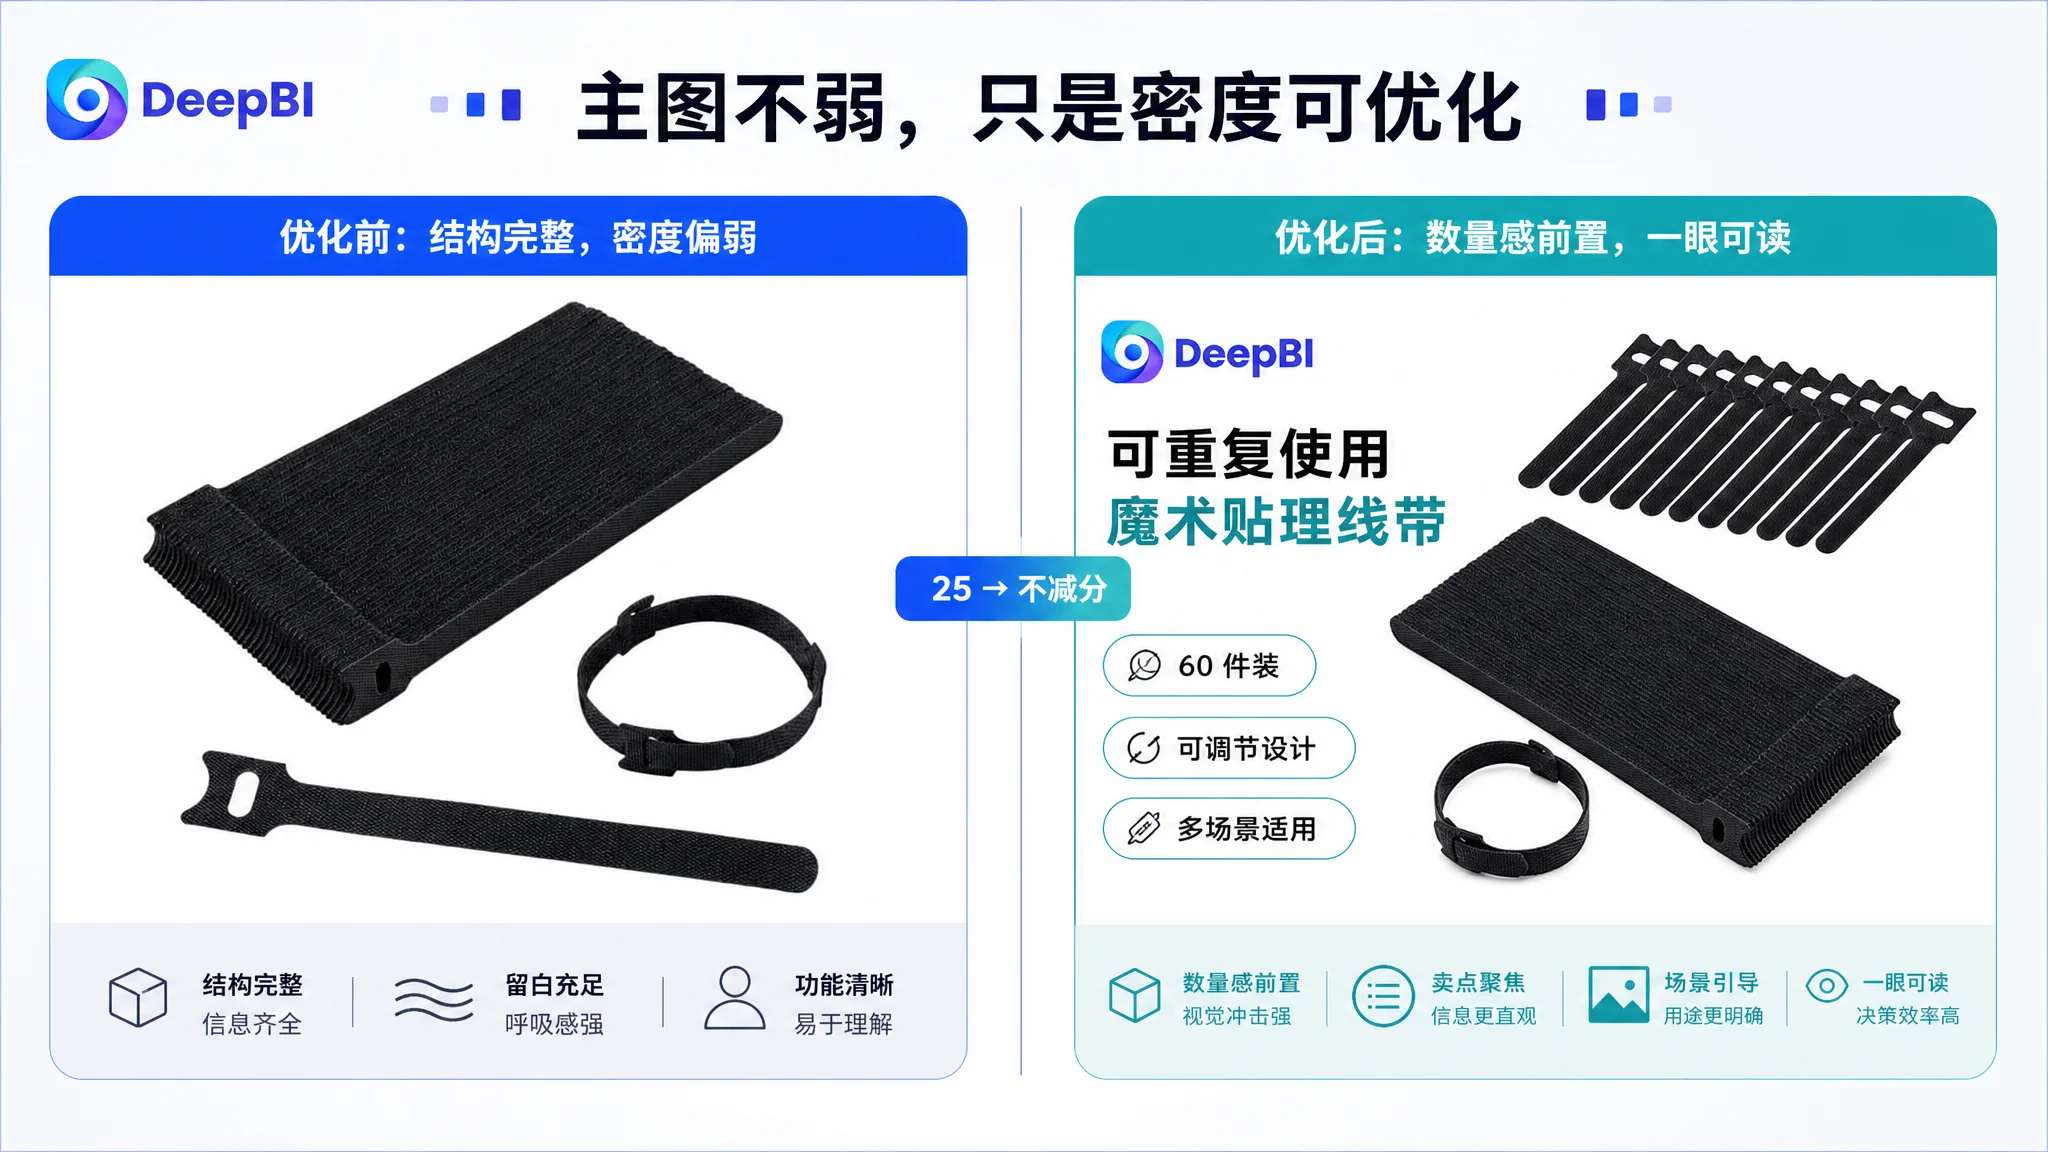
当一个团队反复优化一个已经不弱的地方,通常不是判断错了细节,而是判断错了位置。
广告数据本身也会强化这种误判。ACOS 高,看起来像投放问题;点击有、订单没有,看起来像关键词不够精准。但如果点击进来之后,页面根本没有承接能力,那么所有广告端的优化,本质上只是在调一个“送多少人进空房间”的数字。
20 分丢在一个几乎不存在的地方
详情页的差距不是“做得不够精致”,而是“几乎没有做”。
目标 Listing 的 A+ 内容只有纯文本描述,没有任何图片模块。没有场景图,没有对比图,没有使用步骤图,没有前后对照,没有材质特写。文字本身也是重复性的功能复述。
竞品用的是 6 类高信息密度的图文模块:场景应用、专业对比、使用步骤、Before/After、多场景拼图、产品特性拆解。
这不是一个量级的差距。
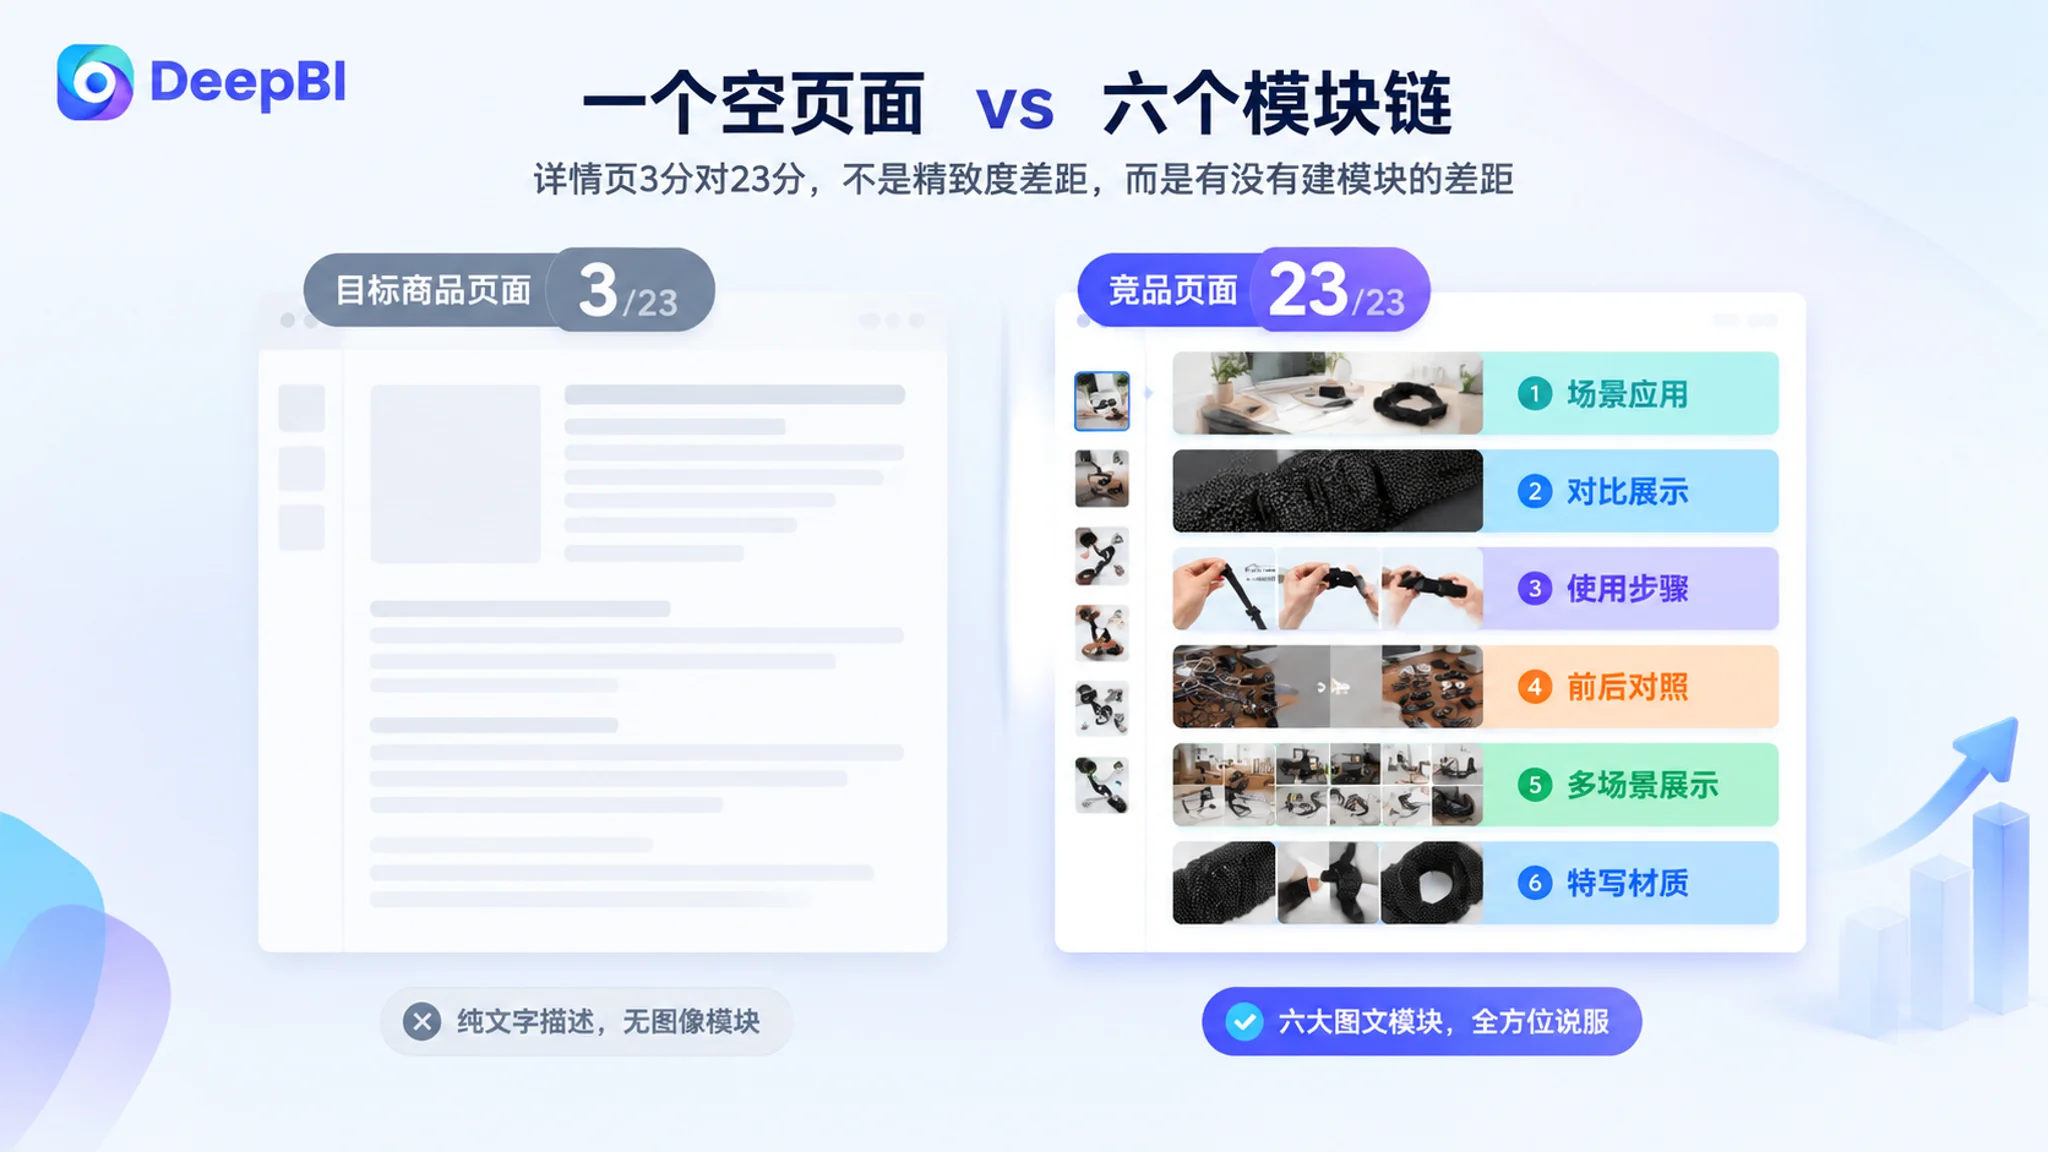
用户在搜索页看到的是主图,决定点不点;用户进入详情页之后看到的是 A+,决定买不买。这条链接的主图足以把人带进门,但门后面是一段没有画面、没有证据、没有场景的说明文。
主图负责让人进来,详情页负责让人留下。这条链接只做好了前半段。
具体缺的不只是图,是四层递进的说服:
第一层,品质信任没有建立。 魔术贴类产品的核心疑虑是“粘不粘得住、会不会用两次就松”。这需要材质特写、抓合力证据、耐久性说明。纯文字说“高质量尼龙”,等于没说。
第二层,易用性没有演示。 竞品用步骤图把“缠绕—按压—完成”的过程拆开,降低决策门槛。目标 Listing 只有一句“可调节、可重复使用”,用户需要自己在脑子里模拟操作。
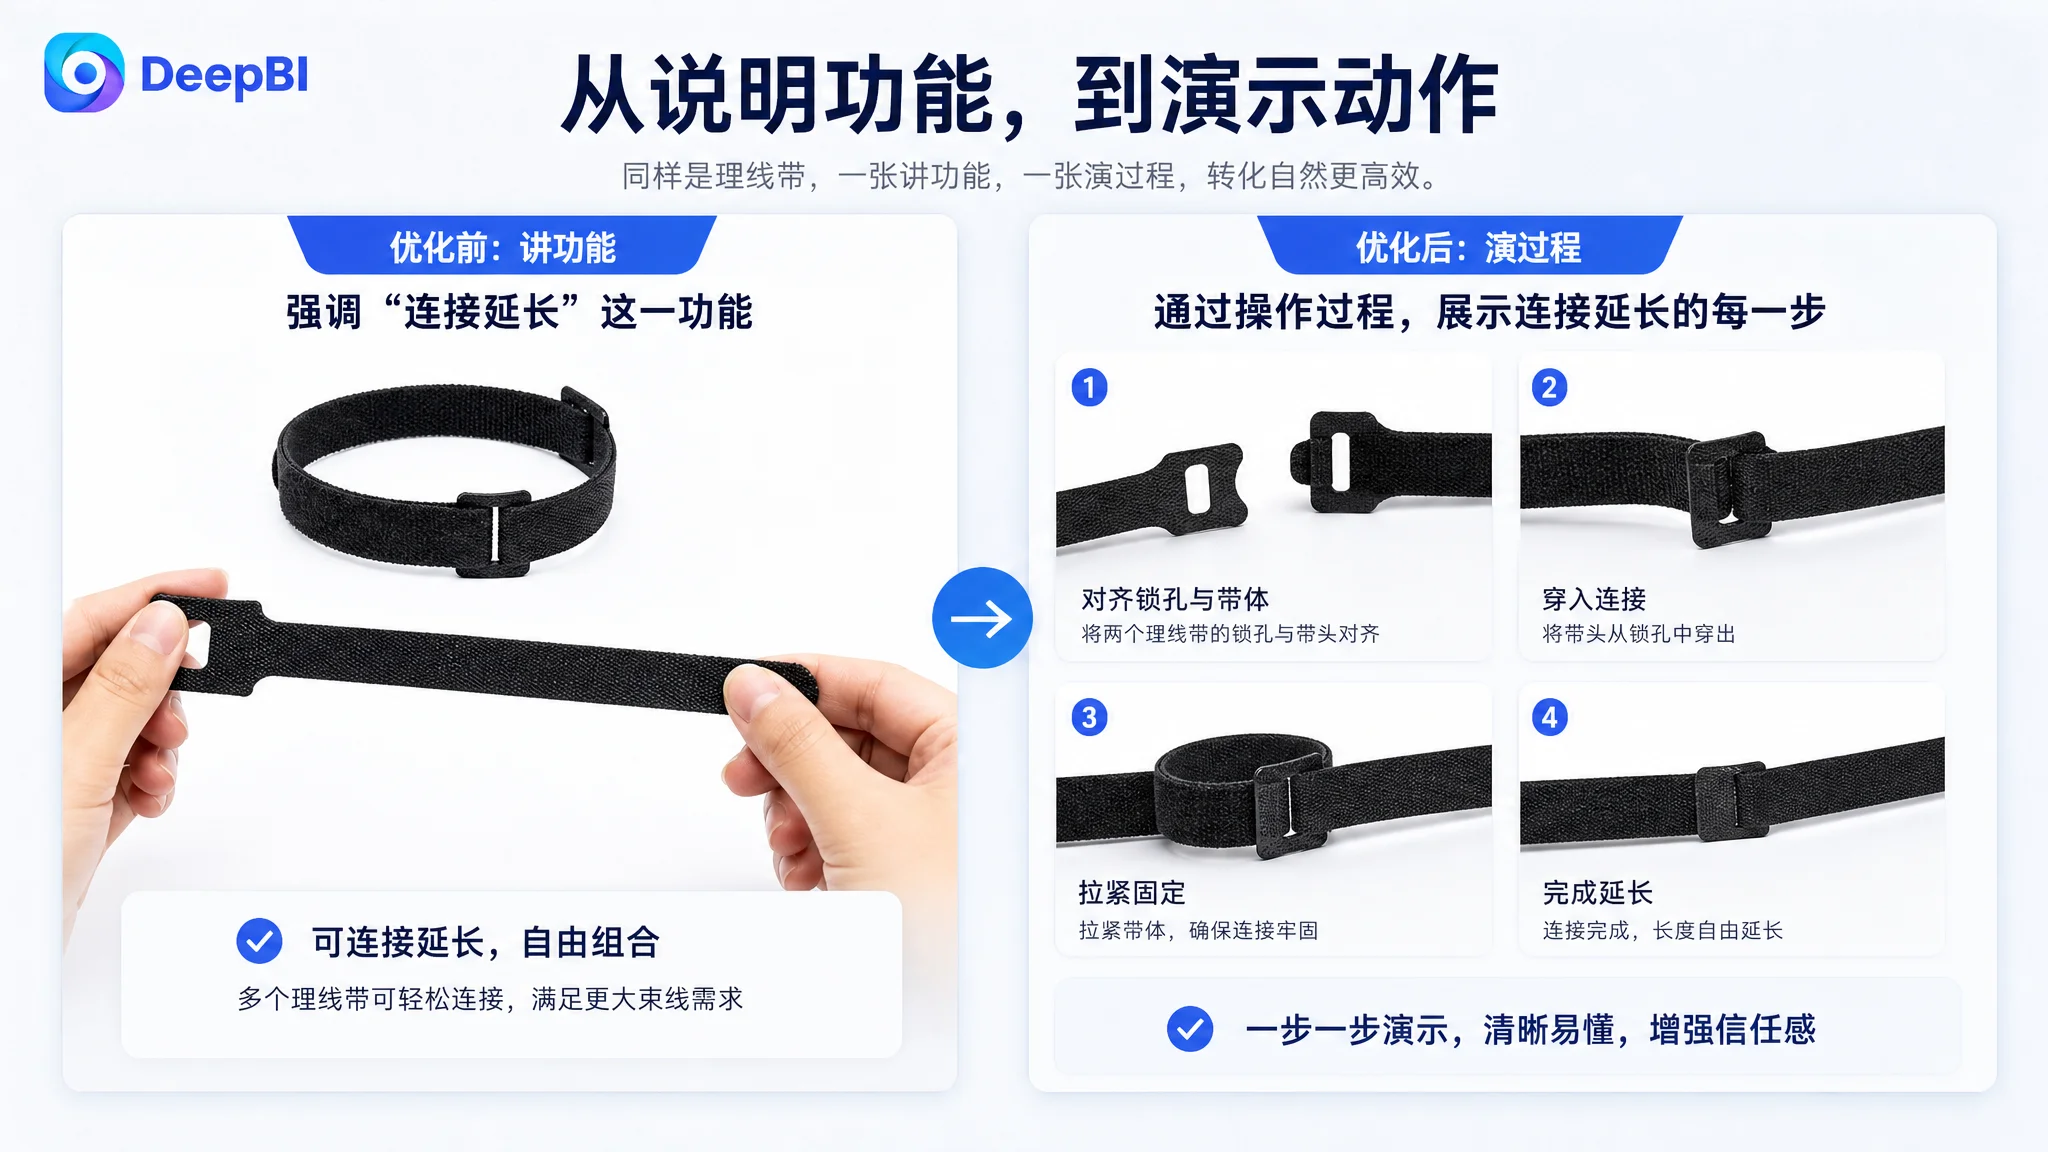
第三层,问题解决效果没有可视化。 前后对比是这类产品最直接的转化模块——乱成一团的线材 vs 整齐的桌面。缺了这块,产品价值就只能靠想象。
第四层,能力边界没有扩展。 用户会问“这东西除了理线还能干什么”。竞品用多场景实拍回答了这个问题,也顺带打开了办公、家居、机房等更宽的联想空间。
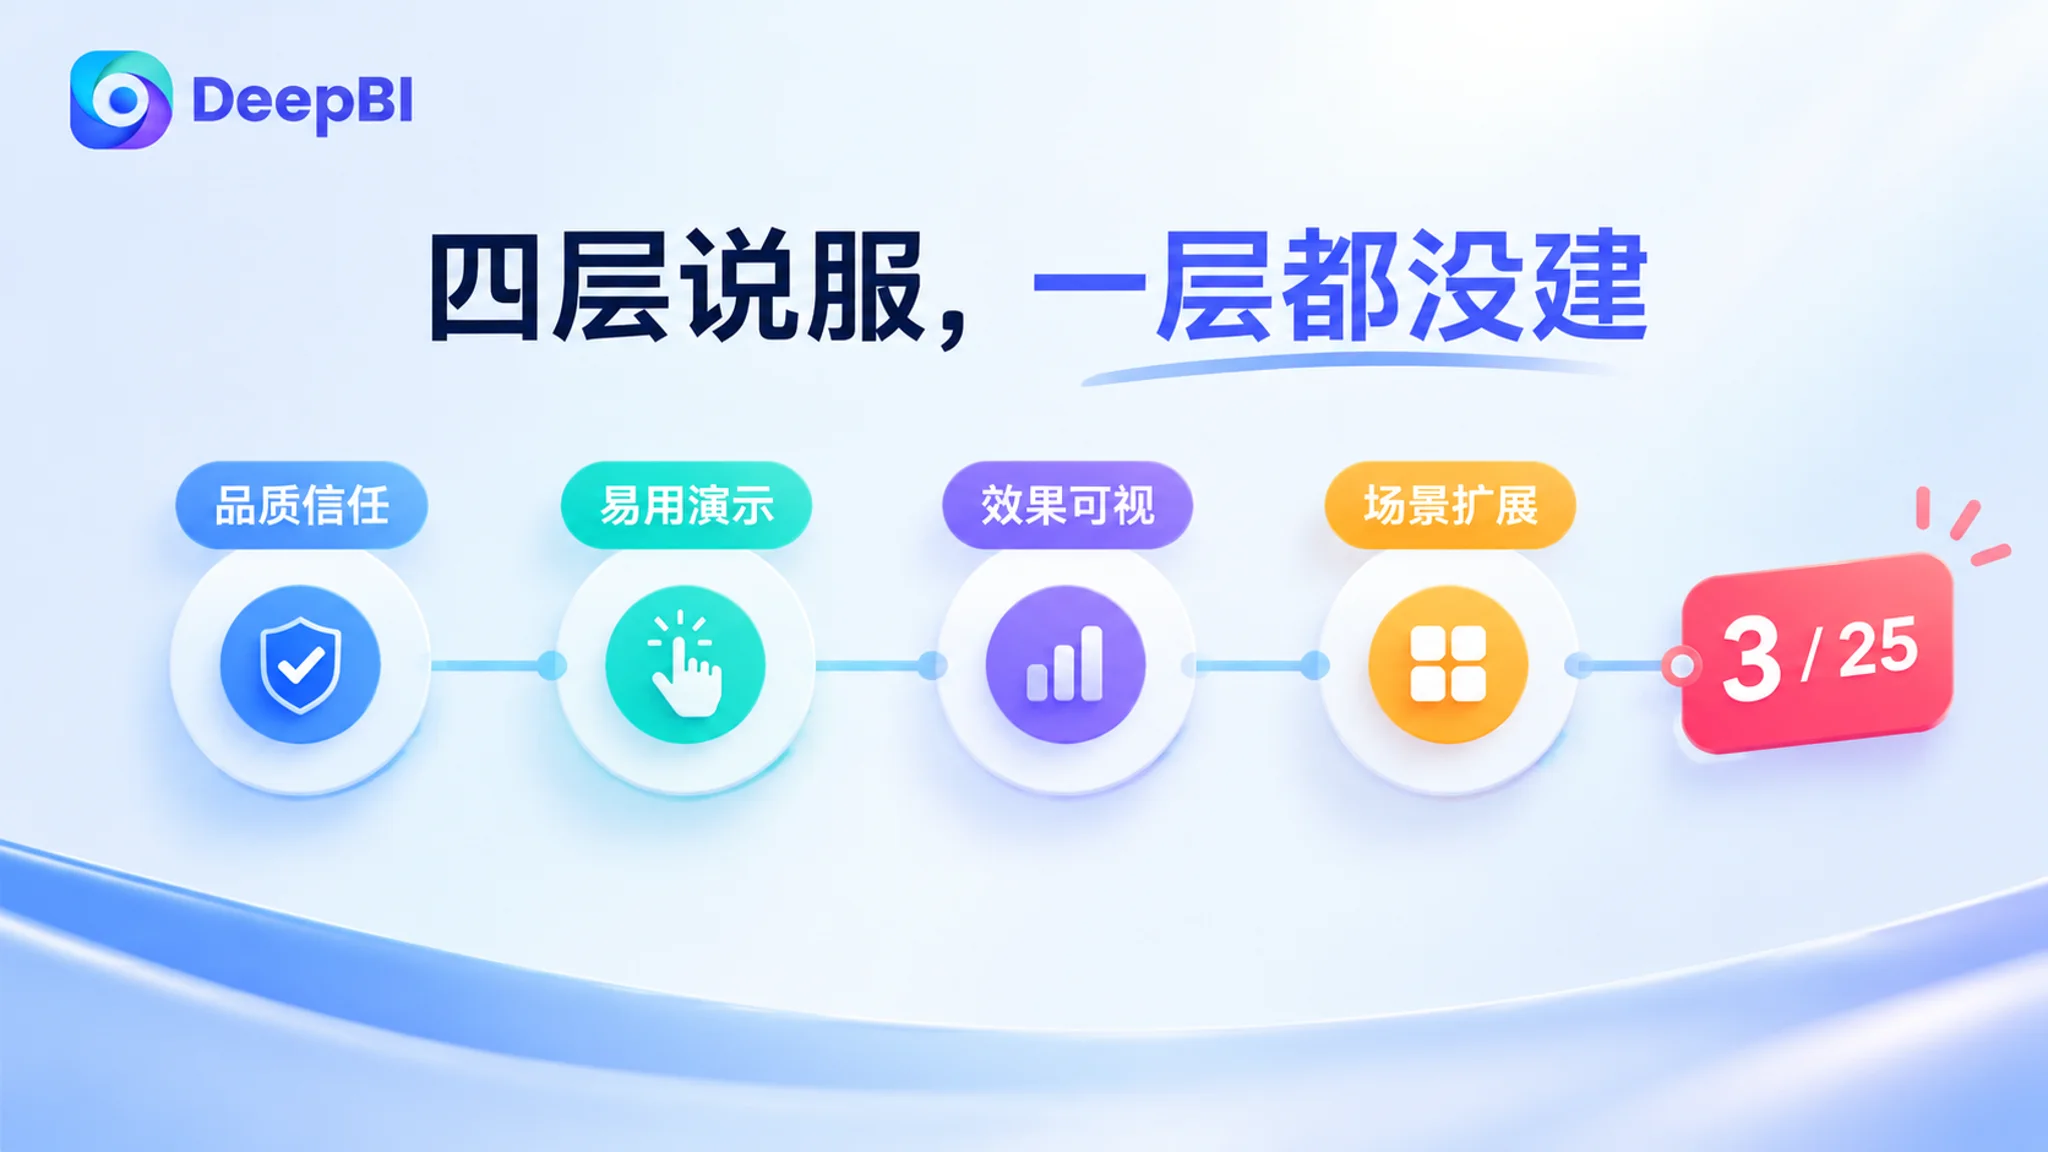
这四层在目标 Listing 上全部缺失。3 分不是评价,是“未开工”。
标题差的 3 分,不是词少,是场景没进来
标题的差距看起来不大,但性质很典型。
竞品的结构是:数量 + 核心词 + 卖点 + 应用场景。它用“70 PCS”开头,数量感前置;核心词密集连排,Cable Ties、Reusable、Cable Management、Adjustable、Cable Organizer 一路铺下来;后半段还补了 Cable Straps、Cord Wraps 两个同义入口,最后落到 Computer、Gaming、Desk、Home Office Essentials。
目标 Listing 是“60 Pack”开头,核心词只覆盖了 Cable Ties 和 Cord Organizer,场景词基本没有。
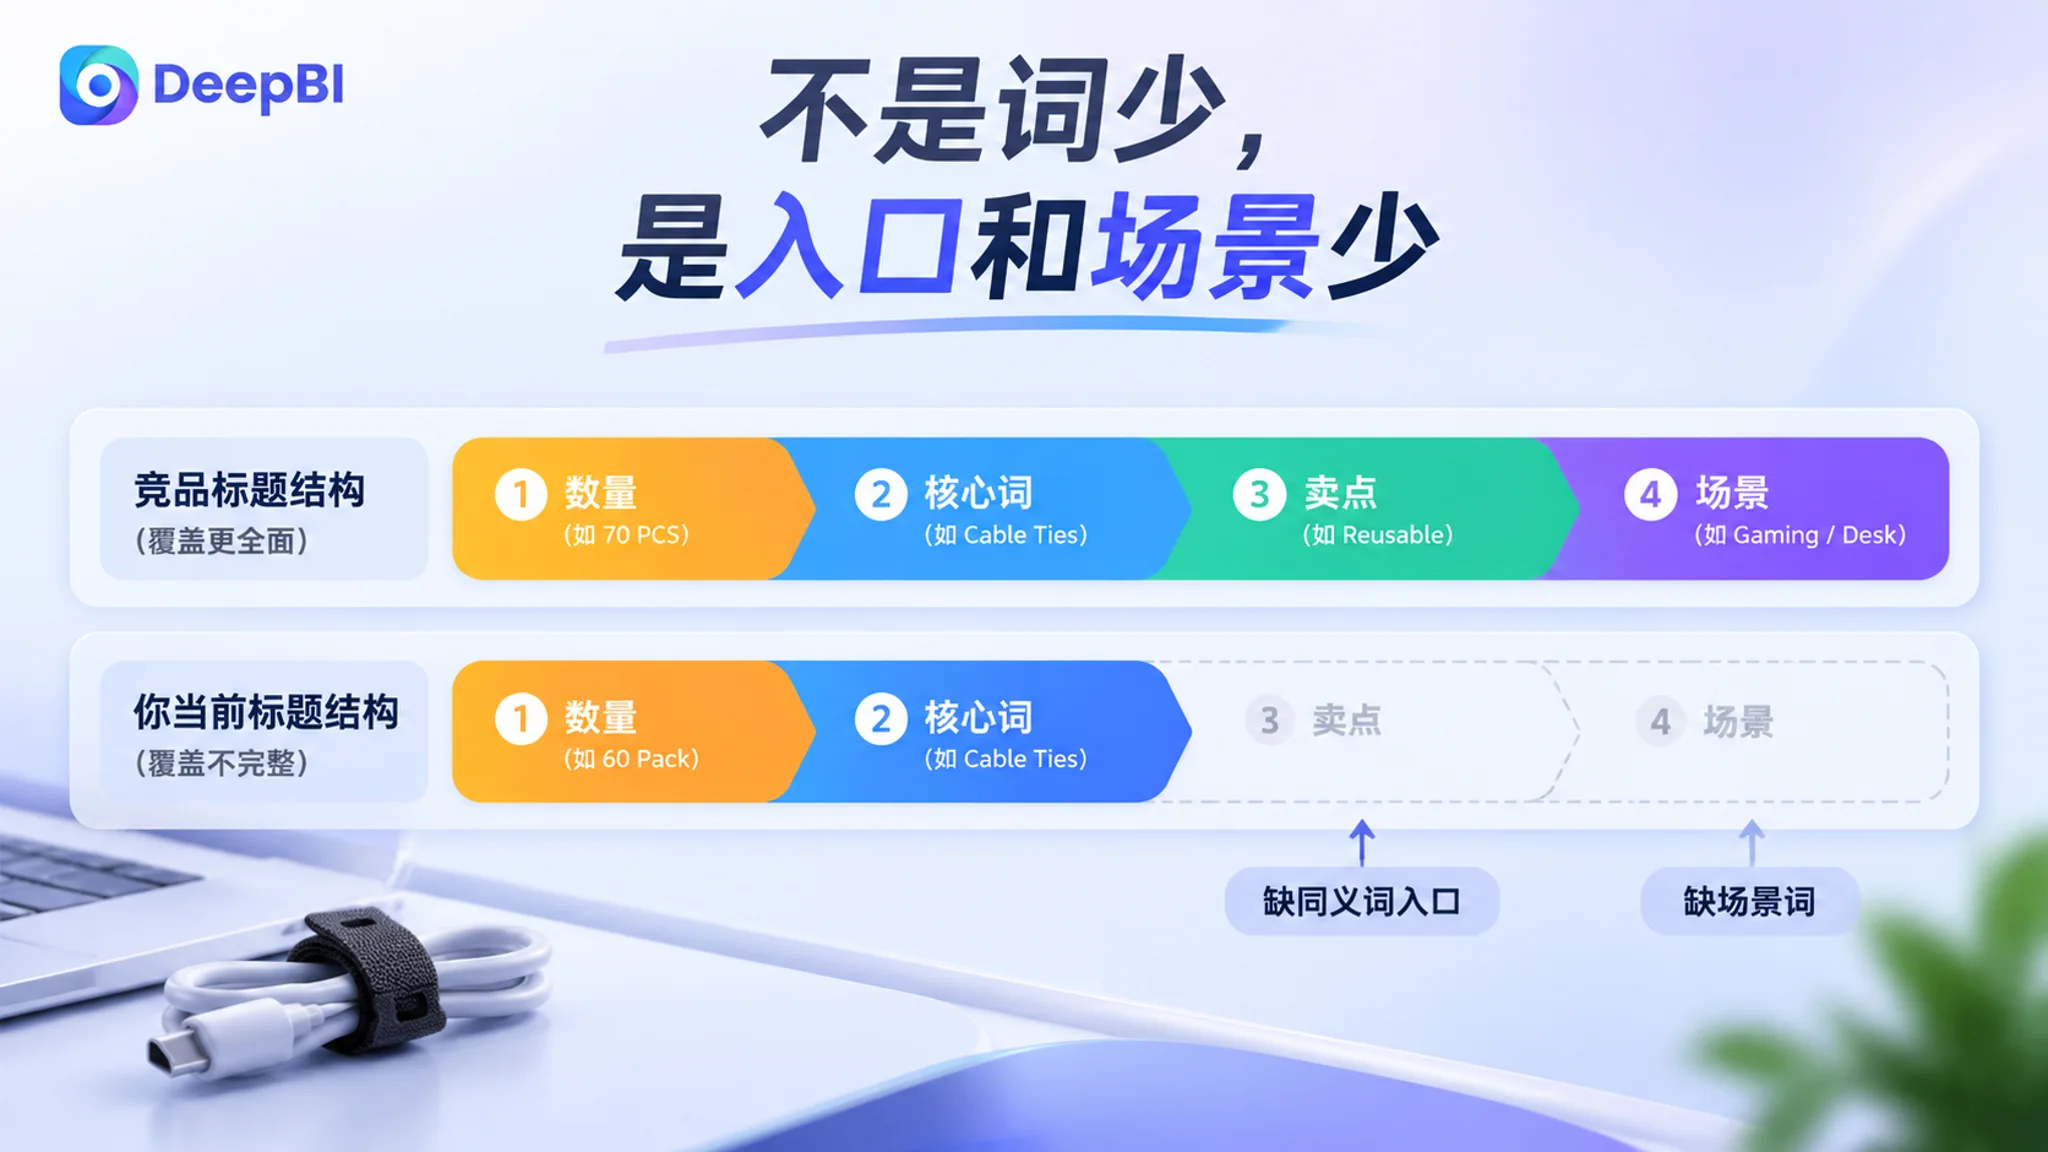
差距不在核心词对不对,而在两个地方:
一是同义词入口窄。 用户搜“理线”这件事,可能用 Cable Ties,也可能用 Cable Management、Cord Wraps、Cable Straps。少一个入口,就少一批流量。
二是场景词缺位。 用户不只是搜“这是什么”,也在搜“我这种情况能不能用”。Gaming、Desk、Home Office 这类词承担的是“确认适用性”的功能,缺了它们,标题只完成了产品识别,没完成需求匹配。
另外,“Pack”和“PCS”在搜索习惯里的权重差异,也是这类目里常被忽略的细节。
标题的问题不是写得太短,是写得只像产品名,不像购买理由。
五点差的 3 分,参数没有变成购买理由
五点的差距更明显,因为它是结构性的。
竞品每一条都以用户的负面体验或痛点开头:
- “Never Use Disposable Ties Again”
- “No More Cutting & Wasting Plastic”
先制造共鸣,再给方案,最后给证据。每一条独立完成一次说服闭环,句子里塞满可验证的数字和对比——“70-pack”、“3 seconds”、“zero peel-off unlike Others'”。
目标 Listing 的五点以功能名称开头:可重复使用、可调节、魔术贴紧固、多场景适用、60 件装。信息都对,但整段读下来像产品说明书。
- 基础功能(可重复使用): 竞品的结构: 痛点驱动:告别一次性扎带
- 长度参数(可调节): 竞品的结构: 痛点驱动:免剪裁、3 秒完成
- 材质说明(魔术贴): 竞品的结构: 技术证明:工业级锁定力
- 泛化场景(多场景适用): 竞品的结构: 场景扩展:一包解决 70 个问题
- 数量与收纳(60 件装): 竞品的结构: 场景覆盖:适配所有线材
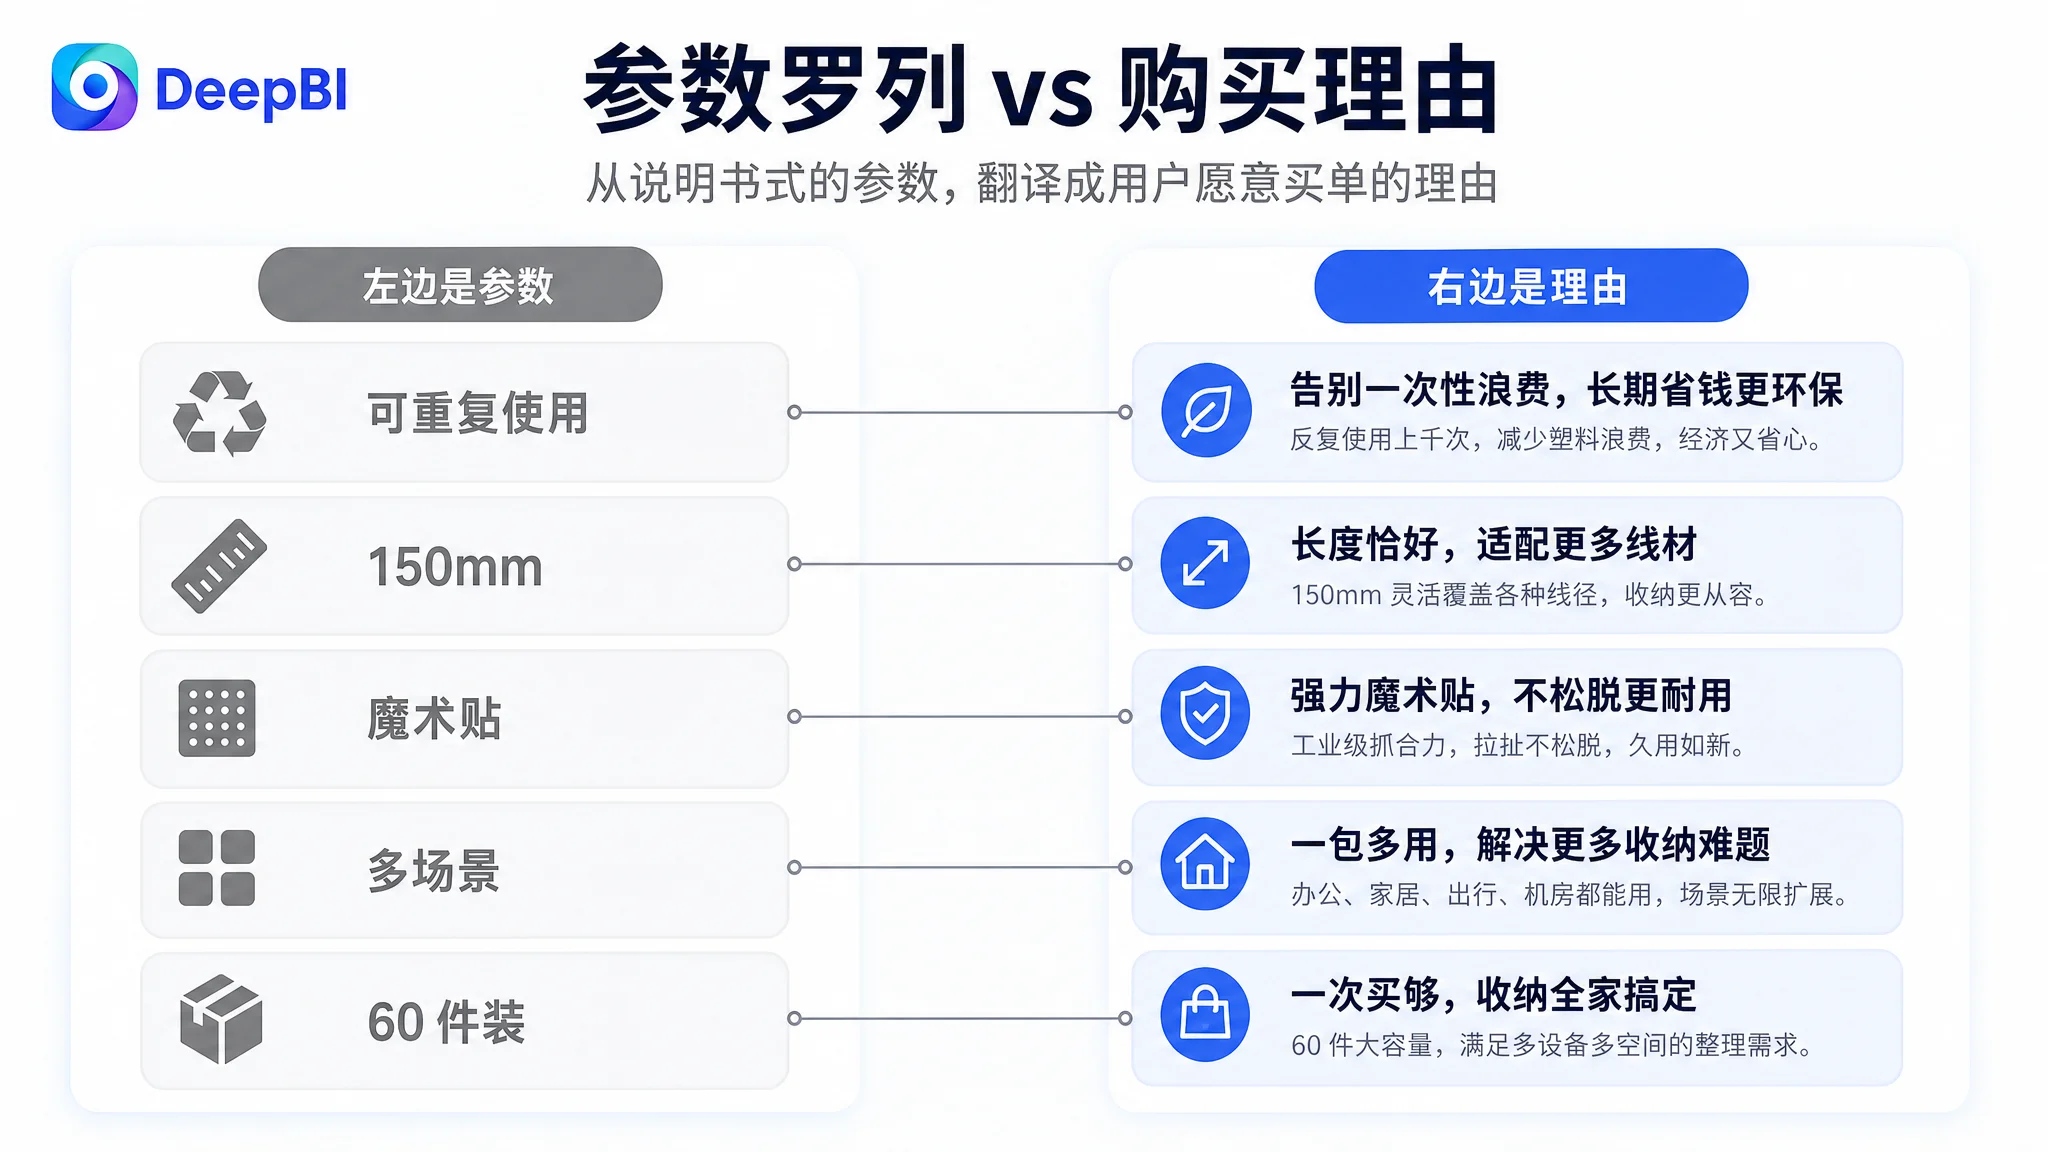
差别的本质是:参数罗列 vs 购买理由。
150mm 是参数,但“3 秒缠好、不用剪、不会勒伤线材”才是理由。60 件是参数,但“一次买够、书桌电视工具箱全搞定”才是理由。
对理线带这种低单价、低决策成本的产品,五点的作用不是科普,是压缩犹豫时间。说明书式的文案会把用户推回“我再看看”,而痛点式文案会把他推向加购。
评价落后 2 分,但这一项现在不能先动
评价维度上,目标 Listing 其实有一个优势被掩盖了:星级 4.9,高于竞品的 4.7,没有差评拖累。
差距在规模。39 条对 161 条,只有对手的 24%。
这确实影响社交证明的强度,也影响用户在“看起来都差不多”的两个选项之间的最终选择。竞品还额外具备 AI 生成的评论摘要和主题标签(功能、粘性、性价比),结构化程度更高,信任增强元素更完整。
但这一项,DeepBI 没有把它排在第一位。
原因很直接:评论增长不可控、周期长、依赖真实订单沉淀。而详情页是一个纯结构性缺口——它不需要等市场给反馈,只要动手就能补。
优先级的判断标准,不是哪一项分差看起来难受,而是哪一项在当前阶段可被真正改变。
星级已经不差,说明产品本身没有信任危机。缺的不是信任,是信任没有被展示出来。这件事,详情页能解决,评论数量解决不了。
为什么没有先继续调广告
这是整个决策里最关键的一步。
从表面看,广告是最痛的地方:ACOS 高、订单不动、团队焦虑。按惯性,下一步应该是继续调关键词、继续试竞价、继续拆广告组。
但这里有一个前提必须先确认:这个页面,值不值得放大流量。
主图 25 分,说明点击环节是通的;详情页 3 分,说明承接环节是空的。在这种情况下加大投放,实际发生的事不是“买来更多订单”,而是“买来更多无效点击”。
广告不会修复一个没有承接能力的页面,它只会更快地把这个页面的缺陷放大。
这也是为什么优化顺序被重新排列:
先补 A+ 承接结构 —— 建立品质信任、演示易用性、可视化问题解决效果、扩展能力边界,让页面具备独立成交的能力。
再修标题与五点 —— 把入口词和场景词铺开,把参数翻译成购买理由,让进来的流量更精准、犹豫时间更短。
评价规模同步推进 —— 但不作为当前阶段的前置条件,因为它不可控。
广告放在最后 —— 等页面能接住流量,再考虑放量。此时广告的作用才从“填补页面的坑”变成“放大页面的优势”。
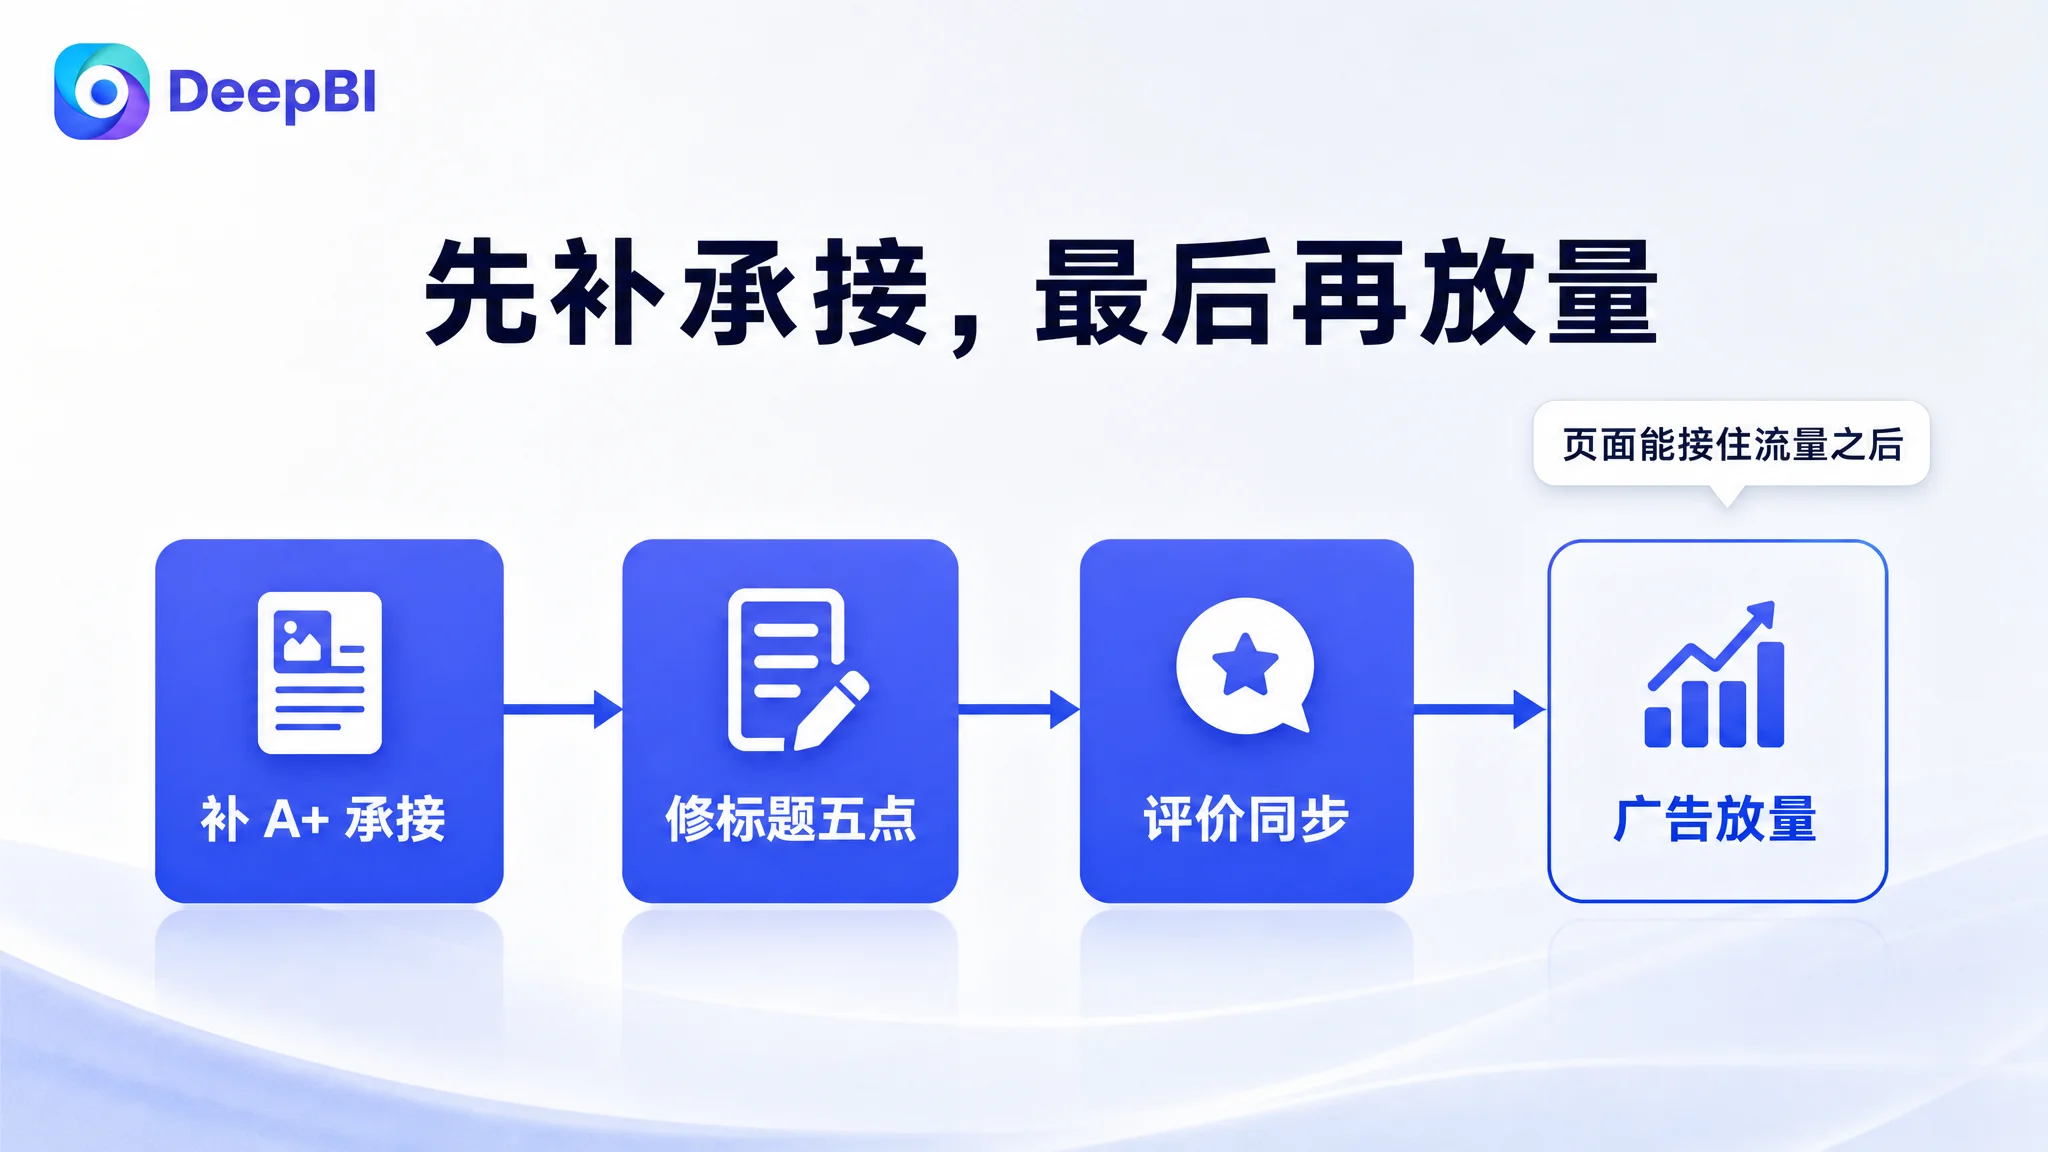
这个顺序不是按分差大小排的,是按“哪一步能让后面的动作变得有效”排的。
页面开始具备成交能力之后,判断也就变了
需要说明的是,这个案例里没有可以引用的优化后数据。所以这里谈的不是结果数字,是结构和判断层面的变化。
结构上,优化方向从“零散的图文补丁”变成了有顺序的模块链:先确认产品身份与核心用途,再建立材质与耐久的信任,然后演示操作与重复使用过程,接着用前后对比把价值做实,再扩展多场景边界,最后用细节特写和混合线径场景收口。七个模块,一条完整说服路径。
风险上,最大的变化是广告不再被当成解决方案。在页面承接能力缺失的阶段继续放量,本质上是在为一个 3 分的详情页持续付费。这条风险线被停了下来。
决策上,优先级从“哪里最痛”转向“哪里最可解”。评价分差更显眼,但不可控;主图看着最该动,但本来就不弱。真正可动、且动了之后能带动全局的,是详情页。
认知上,这是客户团队变化最明显的地方。
他们第一次意识到,广告数据不好,不一定说明广告有问题。
ACOS 高可以来自竞价,也可以来自一个根本没在说服人的页面。CTR 正常、CVR 不动,往往不是流量不准,而是落地之后没有承接。
主图决定用户点不点,详情页决定用户买不买,广告决定这两件事被放大多少倍。三者不是并列关系,是有先后的。
这条链接真正教给同类卖家的事
如果把这次复盘压成一句可复用的判断:
当广告怎么调都救不了转化时,先去看详情页的分数,而不是继续看广告后台。
具体到执行层面,有三个可以自查的信号:
一、主图分数不低,但转化不动。 说明入口没问题,问题在落地页。这时候继续优化主图,收益极低。
二、详情页分数和竞品差出一个数量级。 比如 3 分对 23 分这种差距,通常不是“做得不够好”,而是“模块根本没建”。这种情况下任何广告优化都是在给一个空页面导流。
三、星级健康但评论规模小。 说明产品本身没出问题,只是信任还没有被足够多的人证明。这一项该做,但不该排在详情页之前。
对这条 Amazon 魔术贴理线带 Listing 来说,27 分的差距看起来很大,但拆开之后只有一件事真正致命:它花钱把人请进了门,门后却什么都没有。
修好门后的东西,广告才有意义。
想了解更多DeepBI能为您做什么?
联系我们,获取免费咨询和定制化广告优化方案
